Géron《Hands-On ML》Ch1–9 重點整理:前九章怎麼串成一條路?¶
難度:入門。適合正在讀這本書、或想照教科書順序複習的人。 整理自《Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow》3rd ed.(Aurélien Géron, O'Reilly 2022)第 1–9 章。 本頁定位:照書走章節,收書中獨有的推導與細節。跨章共通的主題(bias-variance、正則化、樹模型家族比較)以〈ML 核心觀念〉為完整版,本頁對應處指過去,不重寫一遍。
前言¶
這本書前九章常被當成「scikit-learn 使用手冊」讀,一章一個模型。這樣讀容易記住 API,卻看不出章節之間的關係。
本頁回答三個問題:
- 前九章怎麼串成一條線?(先講結論:Ch1 建立世界觀,Ch2 走一遍完整專案,Ch3–4 講評估和訓練原理,Ch5–7 是三大經典模型家族,Ch8–9 進入非監督。Ch2 是全書的骨架,後面每一章都是在把 Ch2 的某一步做深。)
- 哪些內容是這本書獨有、本區其他頁沒寫的?(Normal Equation、threshold 調整、OvR/OvO、SVM 的 C 與 γ、CART、OOB、Stacking、PCA、K-Means/DBSCAN/GMM。)
- 每一章最容易誤用的地方在哪?(每章最後一個「常見誤解」框。九個裡有五個和資料洩漏或評估方式有關。)
全書心智圖¶
第 1–9 章是一條路:先建立 ML 的世界觀(Ch1),走一遍端到端專案(Ch2),再逐一深入分類與評估(Ch3)、線性模型與訓練原理(Ch4)、三大經典模型家族(Ch5 SVM、Ch6 樹、Ch7 集成),最後進入非監督的兩支主力——降維(Ch8)與分群(Ch9)。
| 章 | 主題 | 一句話重點 |
|---|---|---|
| Ch1 | ML 全景 | ML 是「從資料學規則」,規則太複雜或會變就用它 |
| Ch2 | 端到端專案 | 測試集最後才碰,用 Pipeline 防 leakage |
| Ch3 | 分類 & 評估 | imbalanced 不能看 accuracy,看 P/R/F1/AUC |
| Ch4 | 訓練模型 | 梯度下降是訓練核心,正則化是抗過擬合主力 |
| Ch5 | SVM | 最大化 margin,kernel 把非線性丟到高維變線性 |
| Ch6 | 決策樹 | 白盒、不需縮放,但易過擬合、不穩定 |
| Ch7 | 集成學習 | 三個臭皮匠:Bagging 降變異、Boosting 降偏差 |
| Ch8 | 降維 | PCA 抓最大變異方向;t-SNE/UMAP 只拿來視覺化 |
| Ch9 | 非監督 | K-Means 要先定 k,DBSCAN 找任意形狀+抓離群 |
Ch1|The Machine Learning Landscape(ML 全景)¶
核心定義¶
- Arthur Samuel (1959):讓電腦不需明確程式設計就能學習的研究領域。
- Tom Mitchell (1997):程式在任務 T 上、用評估指標 P 衡量的表現,隨經驗 E 提升,就稱為「學習」。
什麼時候 ML 比傳統程式設計好?¶
- 規則太複雜或根本不知道(垃圾郵件、語音辨識)
- 環境會變、需要持續適應(詐欺偵測)
- 資料量大到人工規則無法維護
- 想反過來用模型幫人理解問題(Data Mining)
ML 系統的三條分類軸¶
- 是否有監督:Supervised/Unsupervised/Semi-supervised/Self-supervised/Reinforcement。
- 能否增量學習:
- Batch(離線):一次訓練好,定期整批重訓。
- Online(線上):持續吃新資料即時更新;
learning_rate太高會「忘掉」舊資料。 - 如何泛化:
- Instance-based:記住樣本、用相似度預測(KNN)。
- Model-based:從資料建模型再預測(線性回歸)。
完整 ML 專案流程(全書主軸)¶
定義問題(商業目標)→ 收集資料 → EDA → 資料準備(特徵工程)→ 選模型訓練 → 調超參數 → 部署監控。
常見陷阱¶
- 資料面:資料不足、不具代表性(Sampling Bias)、品質差(異常/缺失)、無關特徵(garbage in, garbage out)。
- 模型面:Overfitting(記住雜訊)、Underfitting(太簡單抓不到結構)。
No Free Lunch 定理¶
沒有任何模型在所有問題上都最好。必須依資料與問題選模型,並用交叉驗證比較。
常見誤解:資料越多越好,怎麼來的不重要
1936 年 Literary Digest 寄出約一千萬份美國大選民調,名單取自電話簿、雜誌訂戶這類偏富裕的族群,回覆率又低。結果預測 Landon 勝選,實際是 Roosevelt 大勝。 樣本量再大,只要和真實母體不一致(sampling bias),模型學到的就是另一個世界。先問資料是怎麼來的,再問有多少。
Ch2|End-to-End ML Project(端到端專案)¶
以加州房價預測為例走完整流程。這章是全書的骨架。
Step 1:定義問題¶
從商業目標 → 技術問題 → 評估指標。輸出連續 → 回歸;釐清可接受誤差、上下游 pipeline 的資料格式。
Step 2:載入與快速瀏覽¶
import pandas as pd
df = pd.read_csv('housing.csv')
df.head(); df.info(); df.describe()
df['ocean_proximity'].value_counts()
Step 3:先切測試集(最關鍵)¶
必須在 EDA 之前切,否則你的眼睛「看過」測試集就等於 leakage。imbalanced 時用分層抽樣:
from sklearn.model_selection import train_test_split, StratifiedShuffleSplit
import numpy as np

df['income_cat'] = pd.cut(df['median_income'],
                          bins=[0, 1.5, 3.0, 4.5, 6., np.inf], labels=[1,2,3,4,5])
split = StratifiedShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
for tr, te in split.split(df, df['income_cat']):
    strat_train, strat_test = df.loc[tr], df.loc[te]
Step 4:EDA(只在訓練集上做)¶
分佈圖 df.hist()、地理散佈圖、相關係數 df.corr()['median_house_value']、scatter_matrix。
Step 5:資料準備用 Pipeline 包起來¶
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer

num_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler',  StandardScaler()),
])
full_pipeline = ColumnTransformer([
    ('num', num_pipeline, num_attribs),
    ('cat', OneHotEncoder(), ['ocean_proximity']),
])
housing_prepared = full_pipeline.fit_transform(strat_train)
Step 6–7:多模型比較 → 調參¶
先用 cross_val_score 比較 LinearRegression/DecisionTree/RandomForest,再對最佳者用 GridSearchCV/RandomizedSearchCV 調參。CV 分數比 training score 可信。 參數少、範圍明確用 Grid;參數多或第一次探索用 Randomized,常見做法是先 Randomized 縮小範圍,再 Grid 精調。
常見誤解:EDA 時看一下測試集沒關係
看過測試集的分布,之後在特徵選擇、缺失值填補、甚至分箱邊界上,都會不自覺地針對它做決定。 後果是測試分數偏樂觀,上線後變差,而且你說不出是哪一步造成的。所以 Géron 把「先切測試集」放在 EDA 之前。
Ch3|Classification(分類與評估指標)¶
主軸是 MNIST 手寫數字辨識,從二元分類「是不是 5」切入。
不要相信 Accuracy¶
imbalanced 時,模型只要永遠猜多數類就有高 accuracy。用 DummyClassifier(永遠猜「不是 5」)也能拿到 ~90%。imbalanced 一定要看 F1 或 AUC。
Confusion Matrix → Precision / Recall¶
from sklearn.model_selection import cross_val_predict
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score

y_pred = cross_val_predict(sgd_clf, X_train, y_train_5, cv=3)
confusion_matrix(y_train_5, y_pred)
precision_score(...)  # 預測為正的,多少真的是正
recall_score(...)     # 所有真正的正,抓到多少
f1_score(...)         # 兩者調和平均
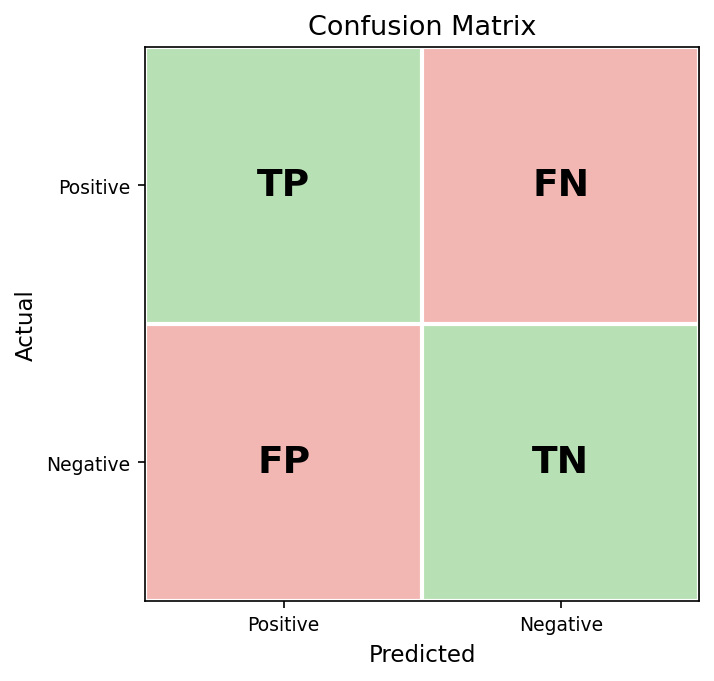 圖:混淆矩陣。對角(TP/TN)為答對;FN=漏報、FP=誤報。Precision=TP/(TP+FP)、Recall=TP/(TP+FN)。
Threshold 調整與業務情境¶
用 decision_function 取分數,畫 precision-recall 曲線後依情境定 threshold:
- 癌症篩檢 → 調低 threshold → 拉高 Recall(寧可誤報)
- 垃圾郵件 → 調高 threshold → 拉高 Precision(不誤判重要信)
ROC / AUC 與曲線選擇¶
roc_curve + roc_auc_score。Positive 樣本很少(imbalanced)用 PR curve,因為 ROC 的 FPR 會被大量 Negative 稀釋,看起來漂亮卻不真。
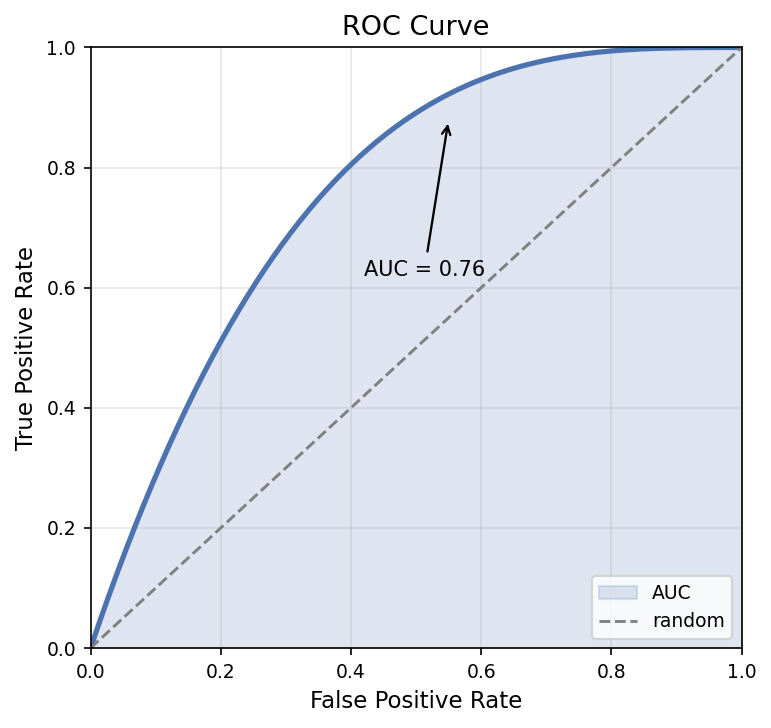 圖:ROC 曲線越往左上、AUC(曲線下面積)越大;對角虛線=隨機猜測(AUC=0.5)。
多元分類:OvR vs OvO¶
- OvR:訓 N 個「是不是這類」,選分數最高。快。
- OvO:訓 N×(N−1)/2 個,每對一個,投票。SVM 因訓練時間對資料量敏感而偏好 OvO。
常見誤解:Accuracy 99% 就是好模型
99% 正常、1% 詐騙的資料,全部猜「正常」就有 99%,但詐騙一個都沒抓到。書中的 DummyClassifier(永遠猜「不是 5」)在 MNIST 上也有約 90%。
不平衡資料要看 Precision、Recall、F1 或 PR 曲線;正例很少時 ROC 會被大量負例稀釋而顯得漂亮(實測見〈模型評估與 Cross-Validation 實務〉§2)。
Ch4|Training Models(訓練模型:梯度下降與正則化)¶
線性回歸的兩種解法¶
- 解析解 Normal Equation:
θ = (XᵀX)⁻¹Xᵀy。要求逆矩陣,複雜度 O(n³),特徵數大就很慢(~10 萬就不可行)。 - 梯度下降:對特徵數是線性複雜度,高維時改用它。
Polynomial Regression¶
線性模型也能學非線性——加入次方項即可(PolynomialFeatures(degree=2) 把 [x] 變 [x, x²])。degree 太高會 overfit。
Learning Curve(診斷 bias/variance 的工具)¶
用 learning_curve 畫訓練/驗證誤差對資料量的曲線——這是本章提供的診斷工具;曲線形狀怎麼判讀、判讀完各自該怎麼救,見〈ML 核心觀念 §2 Bias-Variance〉的診斷表與解法清單。
正則化線性模型¶
Ridge / Lasso / Elastic Net 的懲罰項、效果與選用時機,完整比較表見〈ML 核心觀念 §5 正則化〉。
本章要補的是書中特別強調、比較表放不下的兩個實作陷阱:
- 參數方向不一致:
Ridge/Lasso的alpha越大正則化越強;LogisticRegression的C = 1/λ,越小才越強。兩者方向相反,調參時最容易調反。 - 必須先標準化:正則化懲罰的是係數大小,特徵尺度不一時,大尺度特徵的係數天然較小、被罰得少,懲罰就變成跟尺度相關而非重要性相關。
Early Stopping¶
驗證誤差開始回升就停止訓練。本質上是一種正則化:訓練越久,模型越會記住雜訊;提早停,效果和 L2 類似。
常見誤解:有解析解,就比梯度下降好
Normal Equation 一步算出答案,但要對 XᵀX 求逆,複雜度大約是特徵數的三次方。特徵到十萬等級就算不動,資料大到放不進記憶體也不行。
梯度下降對特徵數是線性的,還能分批吃資料。所以實務上大型線性模型反而多用梯度下降(例如 SGDRegressor)。
Ch5|Support Vector Machines(SVM 與 Kernel Trick)¶
核心直覺¶
目標是找最大化 margin的決策邊界;落在邊界上的點叫 Support Vectors(移掉其他點不影響邊界)。
Hard vs Soft Margin¶
- Hard:所有點必須在正確側,對 outlier 零容忍,現實幾乎不用。
- Soft:允許少數越界,用
C控制:C 大 → margin 小、不容違規 → 易 overfit;C 小 → margin 大、較簡單。
# SVM 必須先標準化!
svm_clf = Pipeline([('scaler', StandardScaler()),
                    ('svm', SVC(kernel='rbf', C=1.0, gamma='scale'))])
Kernel Trick¶
線性不可分時,映射到高維變線性可分;kernel 的妙處是不真的算高維座標,直接算高維內積。常用核:Linear、Polynomial、RBF(預設最常用,參數 γ)、Sigmoid。 - γ 大 → 單點影響範圍小 → 易 overfit;γ 小 → 範圍大 → 較平滑。
兩大缺點¶
- 樣本數大時很慢(O(m²)~O(m³))。
- 對特徵尺度非常敏感,一定要先標準化。
資料少、特徵維度高(例如文字的 TF-IDF)時,SVM 常常很好用;資料大、特徵雜、需要解釋時,隨機森林通常更省事(快、免標準化)。
常見誤解:SVM 可以直接吃原始特徵
Margin 是用歐氏距離量的。一個特徵範圍 0–10,000、另一個 0–0.1,距離幾乎完全由前者決定,margin 會偏向那個方向。
後果是 SVM 的表現看起來很差,被誤以為「這份資料不適合 SVM」。先 StandardScaler,再下結論。
Ch6|Decision Trees(決策樹)¶
運作原理(CART)¶
逐步找「特徵 k + 閾值 t」把資料切成最「純」的兩組。不純度指標:
- Gini 1 − Σpᵢ²(sklearn 預設、較快)
- Entropy −Σpᵢlog pᵢ(結果相近、稍慢)
抗 overfitting 的超參數¶
max_depth、min_samples_split、min_samples_leaf、max_features、max_leaf_nodes——決策樹極易 overfit,一定要限制。
回歸樹:對新點預測其所屬葉節點內訓練樣本的平均值。
CART 是貪心演算法:每一層只找當下最好的切法。找全域最佳的樹是 NP-hard,所以只能這樣做,代價是結果不保證最佳、而且不穩定。Gini 和 Entropy 結果通常很接近,sklearn 預設 Gini,算得比較快。
優缺點¶
- 優:可解釋(可視覺化)、不需標準化、數值/類別皆可、訓練快。
- 缺:極易 overfit、不穩定(資料小變動 → 樹差很多)→ 這正是要用 Random Forest 的原因。
常見誤解:feature importance 高,就代表這個特徵重要
樹模型內建的 importance 是「訓練時這個特徵讓不純度降了多少」。它看的是訓練集,會把背下來的雜訊也算進去,也偏愛可切點多的連續特徵。 在加州房價上加一欄純亂數,隨機森林的內建 importance 給它 0.018,不是 0(實測見〈模型可解釋性〉)。要判斷重要性,改用測試集上的 permutation importance。
Ch7|Ensemble Learning & Random Forests(集成學習)¶
核心思想¶
多個較弱的學習器組合可能勝過單一強模型——前提是各模型彼此獨立、具多樣性。
Voting¶
- Hard voting:多數決。
- Soft voting:平均預測機率(通常更好,但成員需能輸出機率,
SVC(probability=True))。
Bagging / Pasting 與 OOB¶
- Bagging=有放回抽樣分給各模型;Pasting=無放回。
bootstrap=True/False切換。 - OOB 評估:Bagging 每棵樹平均用到約 63% 樣本,剩 ~37% 沒參與,天然當驗證集(
oob_score=True免費拿到 validation score)。
Random Forest¶
比「Bagging + 決策樹」更好的關鍵:每次分裂只看隨機子集特徵,降低樹間相關性、增加多樣性。Extra-Trees 連分裂閾值也隨機選,更快但 bias 略高。
Boosting¶
本節講書中的 AdaBoost / Gradient Boosting 原理。現代實作(XGBoost / LightGBM / CatBoost)的差異與選型、關鍵超參數,見〈ML 核心觀念 §6 樹模型家族〉。
- AdaBoost:每輪提高上一輪被分錯樣本的權重,最後加權投票。
- Gradient Boosting(業界主力):每棵新樹去擬合前面的殘差。
learning_rate與n_estimators要一起調(學習率小→需要更多樹);subsample<1變 Stochastic GB 可防 overfit;可用staged_predict做 early stopping。
Stacking¶
對各基模型的預測再訓練一個 blender;blender 必須用 hold-out(模型沒見過的資料)訓練,否則學到過度樂觀的權重。
常見誤解:Stacking 的 blender 直接用訓練集的預測來訓練
基模型在訓練集上的預測都很準(它們看過答案),blender 會學到「全部相信最會背的那個模型」。
後果是 stacking 在測試集上比單一最好的基模型還差。blender 一定要用 hold-out 或 out-of-fold 的預測訓練,sklearn 的 StackingClassifier 預設就是用 CV 產生這些預測。
Ch8|Dimensionality Reduction(降維)¶
為什麼降維¶
對抗維度詛咒(高維下資料稀疏、距離失義)、加速訓練、去雜訊,以及最重要的視覺化(壓到 2D/3D)。
PCA¶
找資料變異最大的方向(對共變異矩陣做 SVD,特徵向量=主成分,彼此正交、變異依次遞減)投影。
from sklearn.decomposition import PCA
pca = PCA(n_components=0.95)          # 直接保留 95% 變異
X_reduced = pca.fit_transform(X_train)
pca.explained_variance_ratio_         # 每個主成分解釋的變異比
IncrementalPCA;極高維 sparse(文字)可用 Random Projection。新資料要用訓練集 fit 出來的同一個 PCA 物件 transform,包進 Pipeline 就不會忘。
視覺化專用:t-SNE / UMAP¶
擅長呈現集群結構(UMAP 比 t-SNE 快、更保留全局結構)。拿來看就好,別當特徵前處理——t-SNE 是 transductive,新資料沒有固定函數可 transform;UMAP 雖然有 transform(),嵌入會隨參數與隨機種子變動。
常見誤解:t-SNE 圖上分得很開,就拿它當特徵
t-SNE 沒有固定的轉換函數,新資料進來無法投影到同一個空間;UMAP 雖然有 transform(),嵌入也會隨參數和隨機種子變。圖上的群與群之間的距離,也不一定有意義。
要降維當前處理,用 PCA 這類有明確 fit / transform 的方法,並包進 Pipeline,確保新資料用的是訓練集 fit 出來的那一組主成分。
Ch9|Unsupervised Learning(K-Means / DBSCAN / GMM)¶
K-Means¶
隨機初始化 K 個質心 → 分配最近 → 更新質心 → 反覆至收斂。KMeans++(預設)讓初始質心彼此遠離。選 K:Inertia 手肘圖或 Silhouette Score(−1~1,越高越好)。
限制:假設球形、尺度相近、必須先給 K、對 outlier 敏感。
DBSCAN¶
用密度定群(eps 半徑內鄰居數 ≥ min_samples 即核心點),不需指定 K、能找任意形狀、自動標 outlier(label = −1);缺點是高維表現差。
GMM¶
輸出機率(軟分配,處理群組重疊更自然)、假設橢圓形(比球形靈活),低機率密度樣本可做異常檢測。
| K-Means | DBSCAN | GMM | |
|---|---|---|---|
| 需指定 K | 是 | 否 | 是 |
| 群組形狀 | 球形 | 任意 | 橢圓 |
| 處理 outlier | 否 | 是 | 低 |
| 輸出 | 硬分群 | 分群+outlier | 機率 |
常見誤解:K-Means 跑一次的結果就是答案
K-Means 只保證收斂到局部最佳,起點不同,結果就不同。sklearn 用 n_init 跑好幾次、取 inertia 最小的那次。
就算跑很多次,它仍然假設群是球形、大小相近。狹長或彎曲的群,邊緣的點離自己群的中心反而比較遠,會被分錯;這時要換 DBSCAN 或 GMM,不是加大 n_init。
結論¶
回到前言的三個問題。
前九章怎麼串? Ch2 的端到端專案是骨架:切測試集 → EDA → Pipeline → 比較模型 → 調參 → 最終評估。Ch3–4 把「評估」和「訓練」做深,Ch5–7 擴充「模型」這一格,Ch8–9 補上沒有 label 的情況。
書中獨有的內容? 本頁開頭「本頁定位」列的那些推導與細節:Normal Equation、threshold、OvR/OvO、kernel、CART、OOB、Stacking、PCA、三種分群。
最容易誤用的地方? 九個常見誤解裡,EDA 偷看測試集、accuracy 騙人、importance 偏誤、stacking 用訓練集預測、t-SNE 當特徵,五個都是「評估時用了不該用的資訊」。
延伸:這篇真正想留下的問題¶
這本書的程式碼大多能直接跑,也大多能拿到不錯的分數。但書中反覆出現的提醒,其實是同一句話:分數好看,不代表在新資料上也好看。
每讀完一章、跑完一段範例,我會回頭確認一件事:這個分數,是在模型沒看過的資料上算的嗎?
延伸閱讀(本站)¶
- ML 核心觀念 — bias-variance、正則化、樹模型家族的完整版;跨章主題式整理
- 特徵工程心法 — Ch2 資料準備那一步的實務展開
- sklearn Pipeline 與資料前處理模板 — Ch2 Pipeline 的可複製完整模板
- 模型評估與 Cross-Validation 實務 — Ch2–3 評估流程的深入版,含 Nested CV
- 深度學習訓練基礎 — 接續 Ch10 之後的神經網路訓練
參考資料¶
- Géron, A.《Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow》, 3rd ed.(O'Reilly, 2022),Ch1–9
- 書籍官方程式碼 repo(ageron/handson-ml3)
- scikit-learn User Guide