ML 核心觀念:當模型預測不準時,是太簡單還是太複雜?¶
難度:入門。 知識需求:Python、高中代數。 本頁定位:本區 bias-variance、正則化、樹模型家族的完整說明在這頁。評估指標與 CV 的深入版在〈模型評估與 Cross-Validation 實務〉,本頁 §7、§8 只留簡易評估。 內容參考〈Géron《Hands-On ML》Ch1–9〉。
前言¶
本頁主要回答三個問題:
- 模型預測不準時,怎麼判斷是太簡單還是太複雜?
- 同時看訓練誤差和驗證誤差。兩個都高:太簡單(Underfitting);訓練誤差很低、驗證誤差高:太複雜(Overfitting)。
- L1 和 L2 正則化差在哪?
- L1 會讓不重要的係數剛好變成 0,等於自動選特徵;L2 只會把係數縮小,不會歸零。
- 樹模型為什麼是表格資料的主力?
- 隨機森林靠平均很多棵不一樣的樹來降低變異(Variance),boosting 靠一棵接一棵修錯來降偏誤(Bias)。
- 兩者都不需要特徵縮放,對混雜的表格資料很省事。
本頁架構:
ML 類型(在學什麼)→ Bias-Variance(判斷是什麼原因不準)→ 梯度下降(模型的學習邏輯)
→ 線性 / 邏輯迴歸 → 正則化(怎麼不過擬合)
→ 樹模型家族 → 交叉驗證(怎麼公正評估)→ 評估指標(用什麼數字衡量)
1. ML 三大類型¶
- 監督式:資料有 label,學「輸入→輸出」的對應。
- 迴歸(預測連續值,指標 MAE/MSE/RMSE/R²)。
- 分類(預測類別,指標 Accuracy/P/R/F1/AUC)。
- 非監督式:資料沒有 label,自己找結構。
- 分群(K-Means/DBSCAN)、降維(PCA/t-SNE)、關聯規則(購物籃)。
- 其他:半監督、自監督(BERT 的 masked LM)、強化學習(AlphaGo)。
實務上多數任務是監督式。非監督多用在「label 很貴、先探索」或異常偵測。兩者常搭配使用,例如先用 PCA 降維,再做 K-Means 分群。
2. Bias-Variance Tradeoff:判斷模型是什麼原因不準¶
誤差可以拆成三塊:Total Error = Bias² + Variance + Irreducible Error
- 偏誤(Bias)高 = 太簡單(Underfitting):模型本身就畫不出資料的形狀,例如用直線去擬合一條曲線。
- 變異(Variance)高 = 太複雜(Overfitting):模型把訓練資料的雜訊也背下來,換一批資料答案就大變,例如深度 20 的決策樹。
- Irreducible:資料本身的雜訊,換什麼模型都減不掉。
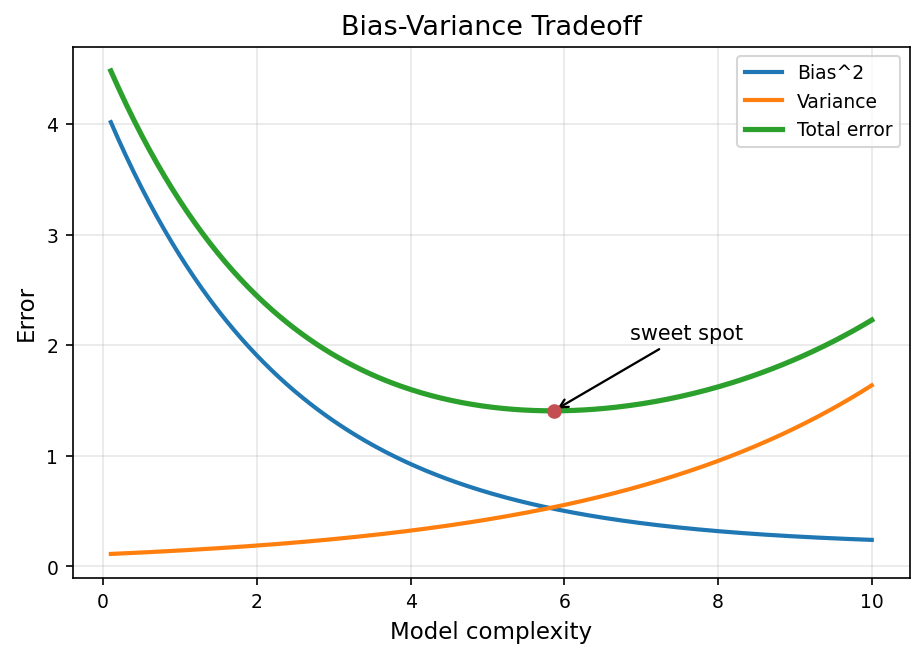 圖:模型複雜度上升 → Bias² 降、Variance 升,總誤差呈 U 型,最低點就是最佳複雜度。
範例¶
我們從 y = sin(x) + 雜訊(雜訊標準差 0.3)抽 60 筆當訓練集、1,000 筆當驗證集,分別用 1 次、3 次、15 次多項式迴歸去擬合:
import numpy as np
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)
x = rng.uniform(-3, 3, 60);   y = np.sin(x) + rng.normal(0, 0.3, 60)
xv = rng.uniform(-3, 3, 1000); yv = np.sin(xv) + rng.normal(0, 0.3, 1000)
for deg in [1, 3, 15]:
    m = make_pipeline(PolynomialFeatures(deg), StandardScaler(), LinearRegression())
    m.fit(x[:, None], y)
    # 分別算訓練集與驗證集的 RMSE
| 次數 | 訓練 RMSE | 驗證 RMSE | 診斷 |
|---|---|---|---|
| 1 | 0.533 | 0.509 | 兩個都高、而且很接近 → 沒學到 → 太簡單(Underfitting) |
| 3 | 0.298 | 0.322 | 兩個都接近雜訊的 0.3 → 剛好 |
| 15 | 0.239 | 0.369 | 訓練比雜訊還低、驗證變差 → 學過頭了 → 太複雜(Overfitting) |
15 次多項式的訓練 RMSE 是 0.239,比雜訊本身的 0.3 還低。這只有一種可能:它把雜訊背下來了。這個訊號比「驗證誤差比訓練高」更直接,因為驗證誤差本來就會比訓練高一點。
診斷規則整理成表:
| 訓練誤差 | 驗證誤差 | 診斷 | 往哪修 |
|---|---|---|---|
| 高 | 高(接近訓練) | High Bias → Underfitting | 加複雜度、加特徵、降正則化、訓練更久 |
| 低 | 高(差距大) | High Variance → Overfitting | 加資料(最有效也最貴)、加正則化、簡化模型、Ensemble、Dropout、Early stopping |
| 低 | 低 | 好模型 | — |
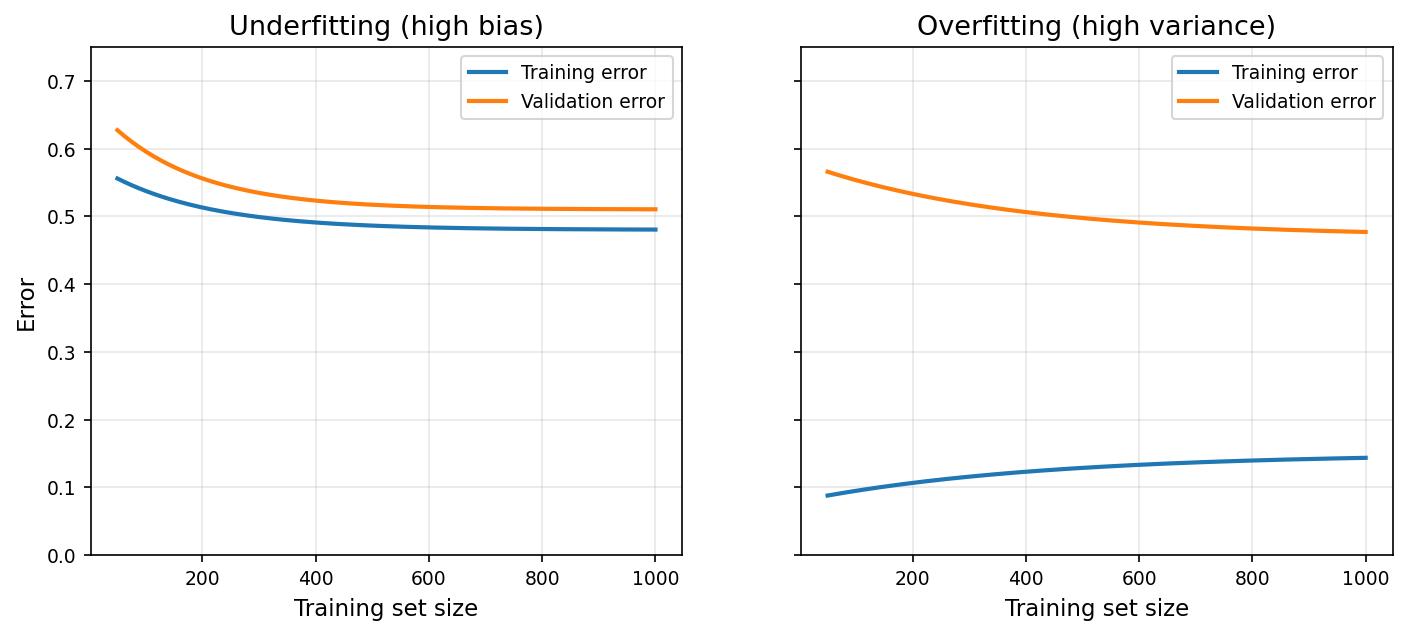 圖:左 underfitting(train/val 都高且收斂在一起);右 overfitting(train 低、val 高、落差大)。
常見誤解:預測不準時該加資料
加資料確實最有效,但它只對 variance 有用。如果是 underfitting(兩條線都高、而且已經收斂在一起),加再多資料,兩條線也只是停在同一個高度。 實際後果:花了很多成本蒐集資料,分數卻沒有改善。調參時先看兩條線的位置,再決定修法。
3. Gradient Descent:模型怎麼學¶
站在目前的位置,看哪個方向能讓 Loss 下降最多,就往那個方向更新參數。重複迭代,直到跑完設定的回合數,或 Loss 不再下降。(可以想像成一顆球在滾,球會一直往低的地方滾,直到滾不動,而學習率就是每一步跨多遠。)
更新公式 θ ← θ − α·∇L(θ)(α 是 learning rate,負號代表往下坡走)。
三種變形:
- Batch:用全部資料算一次梯度。穩,但慢。
- SGD:一筆資料就更新一次。快,但震盪大。
- Mini-Batch(最常用):一小批(32/64/128/256)。能用 GPU 平行計算,小幅震盪還能幫忙跳出不好的局部低點。
Learning rate:太小,收斂很慢;太大,來回震盪甚至發散。常用起點 0.001 或 0.01,搭配 scheduler(先大後小)。
進階優化器(Optimizer):Momentum(加慣性)、RMSProp(每個參數自己調 learning rate)、Adam(兩者結合,多數神經網路的預設)。高維空間裡真正常見的障礙通常不是局部最小值,而是 saddle point(某些方向往上、某些方向往下的平台)。各優化器的細節見〈深度學習訓練基礎〉。
def gradient_descent(X, y, lr=0.01, epochs=1000):
    w, b, n = 0, 0, len(X)
    for _ in range(epochs):
        y_pred = w * X + b
        dw = (2/n) * np.sum((y_pred - y) * X)
        db = (2/n) * np.sum(y_pred - y)
        w -= lr * dw; b -= lr * db
    return w, b
常見誤解:Adam 永遠比 SGD 好
Adam 收斂快、好調,所以是預設。但有不少研究和實務經驗發現,SGD + Momentum 配上好的 learning rate schedule,最終在測試集上可能泛化得更好。 實際後果:只看訓練曲線收斂速度選優化器,可能選到測試分數較差的那個。重要的模型兩種都值得試。
4. 線性迴歸 vs 邏輯迴歸¶
| 項目 | 線性迴歸 | 邏輯迴歸 |
|---|---|---|
| 任務 | 迴歸 | 分類 |
| 輸出 | 連續值 | 機率 [0,1] |
| 激活 | 無 | Sigmoid / Softmax |
| 損失 | MSE | Cross-Entropy |
| 解析解 | 有 | 無(要迭代) |
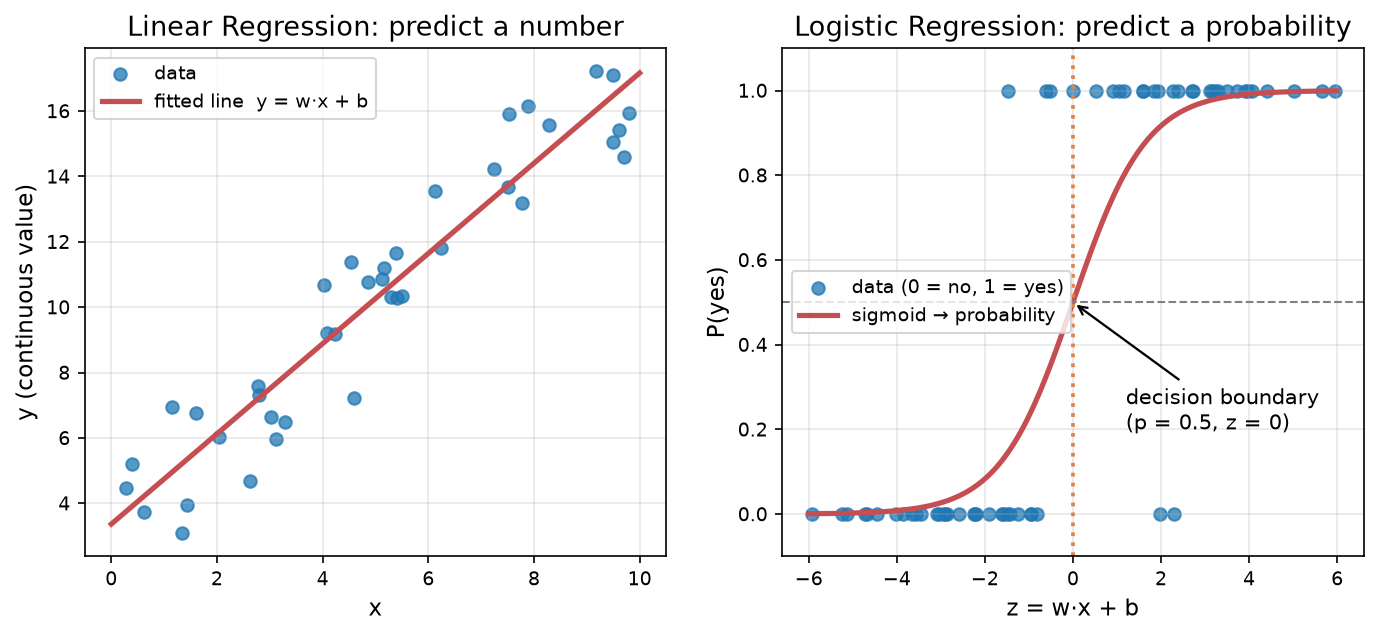 圖:左邊線性迴歸畫一條直線,預測連續的數字;右邊邏輯迴歸把 z 壓進 S 形的 Sigmoid,變成 0 到 1 的機率,機率 0.5(z = 0)就是決策邊界。
- 線性迴歸三假設:
- 線性關係
- 樣本獨立
- 殘差常態 N(0,σ²)
- 邏輯迴歸(Logistic Regression):用來回答「是或不是」的問題,例如這封信是不是垃圾郵件。
- 先跟線性迴歸一樣,把特徵乘上權重再加起來,得到一個分數 z。z 可以是任何數字,例如 -3 或 5。
- 把 z 丟進 Sigmoid 函數
σ(z)=1/(1+e⁻ᶻ),壓成 0 到 1 之間的機率。z 越大,機率越接近 1;z 越小,越接近 0。 - 機率大於 0.5 就判成「是」,否則判成「不是」。機率剛好是 0.5 的地方就是 z = 0,這條分界線是直線,所以叫「線性決策邊界」。
- 超過兩類時(例如分貓、狗、鳥),把 Sigmoid 換成 Softmax。它會一次給出每一類的機率,全部加起來等於 1。
名字裡有「迴歸」,是因為核心還是線性迴歸的 z = w·x,只是多過一層 Sigmoid 變成機率。它是線性模型:決策邊界是一條直線(或超平面)。非線性的問題要靠特徵轉換、kernel SVM 或樹模型。
常見誤解:邏輯迴歸也可以用 MSE 當損失
技術上算得出來,但效果不好,原因有兩個:
- Sigmoid 配 MSE,損失的形狀不是碗(不是凸的):兩邊有很平的地方,梯度下降走到那裡就幾乎不動。
- 模型錯得很離譜時(答案是 1,模型卻說 0.01),Sigmoid 已經被壓平,梯度幾乎是 0,模型學不動。
Cross-Entropy 配 Sigmoid 時,損失的形狀像一個碗(凸的),沒有會騙人的小坑,梯度下降一路往下走就對了。而且錯得越離譜,梯度越大,修正得越快。
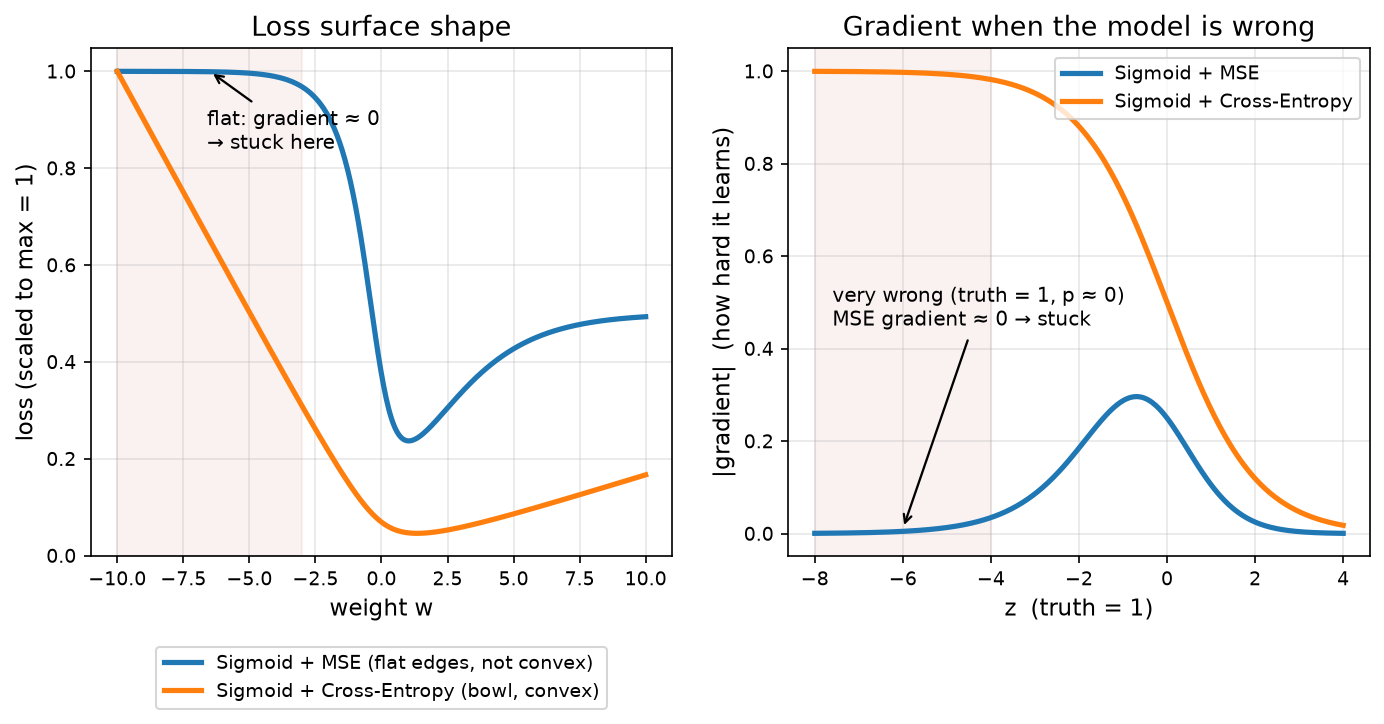 圖:左邊是損失的形狀,MSE 兩側是平的、不是碗,從紅底區域出發會卡住,Cross-Entropy 是一個碗;右邊是答案為 1 時的梯度大小,模型錯得很離譜(左側紅底)時,MSE 的梯度幾乎是 0,Cross-Entropy 還是用力修正。
5. 正則化:L1 / L2 / 其他¶
在損失函數後面加一個懲罰:Loss = 原損失 + λ × 參數懲罰。
- L1(Lasso)
Σ|wᵢ|:不重要的參數直接歸零,等於自動選特徵。適合「特徵很多、只有少數有用」。(L1 是絕對值:係數從 3 降到 2,懲罰少 1;從 1 降到 0,懲罰也少 1。小係數往 0 推的力氣跟大係數一樣,所以小的會被一路推到 0。) - L2(Ridge)
Σwᵢ²:所有參數一起縮小,不會歸零。預設首選,神經網路裡叫 weight decay。(L2 是平方:係數從 3 降到 2,懲罰少 5(9 − 4);從 2 降到 1,懲罰只少 3(4 − 1)。大係數往下降省得比較多,所以會優先壓大的參數。) - Elastic Net:L1 + L2 折衷(
l1_ratio),特徵數大於樣本數、或特徵彼此高度相關時好用。
實驗:100 個特徵,只有 5 個有用¶
from sklearn.linear_model import Lasso, Ridge
X = rng.normal(size=(200, 100))
w = np.zeros(100); w[:5] = [3, -2, 1.5, 1, -1]      # 只有前 5 個有用
y = X @ w + rng.normal(0, 1, 200)
lasso = Lasso(alpha=0.1).fit(X, y)
ridge = Ridge(alpha=10).fit(X, y)
| 係數剛好為 0 的個數 | 前 5 個係數(真值 3, −2, 1.5, 1, −1) | 其餘 95 個裡最大的 |w| | |
|---|---|---|---|
| Lasso α=0.1 | 74 | 2.89, −1.73, 1.33, 0.81, −0.80 | 0.150 |
| Ridge α=10 | 0 | 2.66, −1.68, 1.35, 0.88, −0.83 | 0.219 |
兩者都抓到了前 5 個有用的特徵,係數也都被往 0 拉了一點(這就是正則化的「偏誤」)。差別在剩下的 95 個雜訊特徵:Lasso 把 74 個精確地設成 0,Ridge 讓它們全部保留一個小小的值。
為什麼?看幾何圖:
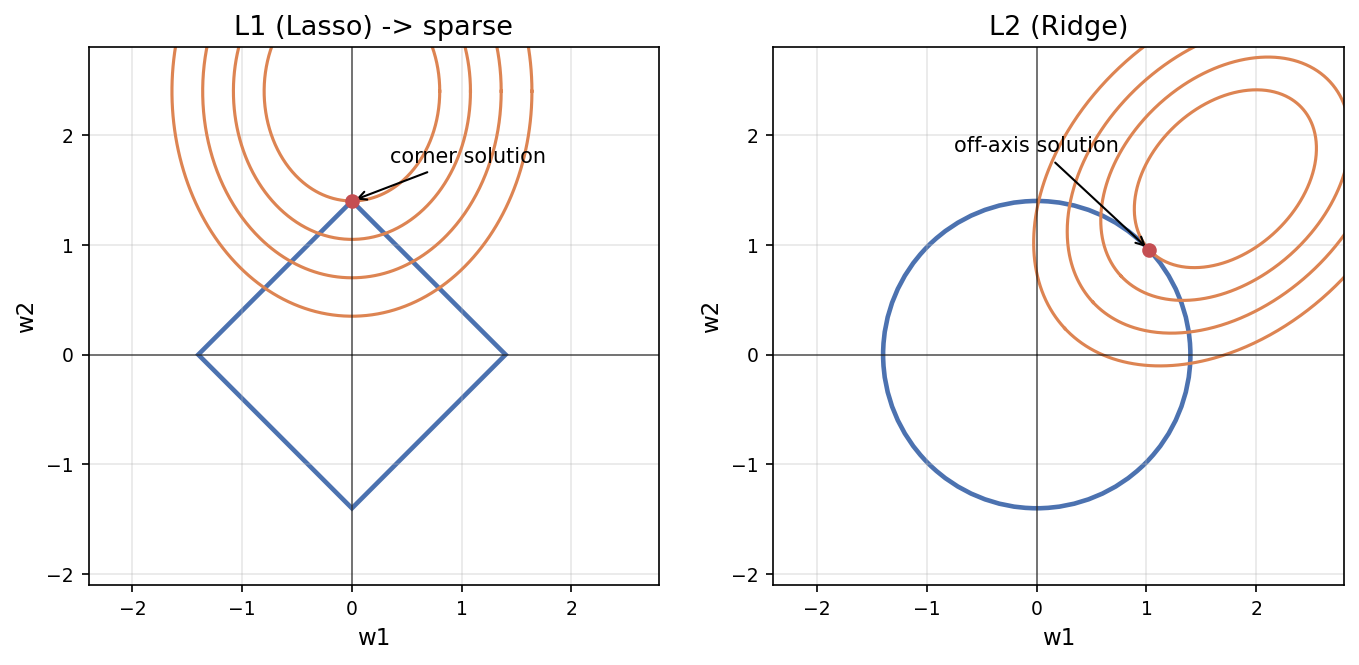 圖:L1 的限制區域是菱形,角落剛好在座標軸上,損失的等高線最容易碰到角落 → 某些權重剛好為 0;L2 是圓形,通常碰在不是軸上的點。
λ(sklearn 叫alpha)用 CV 調:太小會太複雜(Overfitting),太大會太簡單(Underfitting)。注意LogisticRegression用的是C = 1/λ,方向相反,C 越小正則化越強。- 其他正則化:Dropout(神經網路,隨機丟掉 20%–50% 的神經元)、Early stopping、Data Augmentation。細節見〈深度學習訓練基礎〉。
常見誤解:正則化前不用標準化
懲罰的是係數大小。同一個特徵用「公尺」記和用「公分」記,係數差 100 倍,被罰的程度也差很多。
實際後果:不標準化時,懲罰會跟單位有關,而不是跟特徵重不重要有關。用 Ridge、Lasso、邏輯迴歸前,先 StandardScaler。
6. 樹模型家族:RF / XGBoost / LightGBM¶
單棵決策樹幾乎一定太複雜(Overfitting),而且很不穩定:資料小動一下,整棵樹就長得不一樣。實務上不會直接拿來預測,只當 ensemble 的零件。而組成有以下兩條路線:
- Bagging(並行)→ Random Forest:很多棵樹,各自吃一份 bootstrap 抽樣的資料,每個節點又只看隨機一部分特徵,最後投票或平均。降的是變異(Variance)。不容易過擬合、可以平行、預設參數通常就可以得到不錯的效果。關鍵參數:
n_estimators:森林中樹的數量max_features:每次切分時,隨機挑幾個特徵來比(sklearn 預設:分類 √n、迴歸用全部特徵)max_depth:每棵樹要長多深
- Boosting(串行)→ XGBoost / LightGBM / CatBoost:一棵接一棵,每棵新樹專門修前面的錯。降的是偏誤(Bias)。
- XGBoost:預設一層一層長(level-wise);類別變數要開
enable_categorical才原生處理。 - LightGBM:每次切損失降最多的那片葉子(leaf-wise)、大資料上通常比 XGBoost 快、原生支援類別變數;小資料(< 10k 筆)容易過擬合。
- CatBoost:類別變數是強項(ordered target statistics 防洩漏),預設參數就不差。
- 關鍵參數:
max_depth/num_leaves、learning_rate(越小需要越多樹)、n_estimators、early stopping(一定要加)、subsample/colsample_bytree(加隨機性防過擬合)。
隨機森林為什麼不容易過擬合?兩層隨機(抽樣本、抽特徵)讓每棵樹長得不一樣,彼此的錯誤不太相關,平均之後就互相抵消。如果每棵樹都一樣,平均一百棵和一棵沒有差別。
樹模型都不需要特徵縮放:它只看「比某個值大還是小」,把特徵乘以 100,切點也跟著乘以 100,結果完全一樣。
三套 boosting 實際差多少、怎麼調參、什麼時候該用哪個,見〈Gradient Boosting 實戰〉。
常見誤解:Boosting 一定比 Random Forest 好
在調好參數的情況下,boosting 通常分數較高。但它有更多參數要調,對雜訊和過擬合也更敏感;隨機森林幾乎不用調就能有不錯的分數。 實際後果:時間有限、資料雜訊多時,隨機森林是很好的基線。先有一個穩的基線,才知道 boosting 多拿的分數值不值得多花的調參時間。
7. Cross-Validation:怎麼公正評估¶
本節為簡單介紹。CV 的完整選擇邏輯、Nested CV、GroupKFold/TimeSeriesSplit 的程式碼與陷阱見〈模型評估與 Cross-Validation 實務〉。
訓練前會把資料切成訓練集和測試集。只切一次的話,分數會受切資料的運氣影響,樣本小時特別明顯。所以我們常切很多次,再把分數平均,減少單次切分的偶然性。常見的交叉驗證方式如下。
K-Fold:最常見的交叉驗證方法
K-Fold 的做法不複雜。假設設定 K = 5:
- 把資料分成 5 份。
- 第一次拿其中 1 份當驗證集,另外 4 份訓練模型。
- 接著換另一份當驗證集,重複到每份資料都被驗證過。
- 最後把 5 次的驗證分數取平均。
比起只切一次資料,這樣通常能更穩定地估計模型表現。
變形:
為了因應不同的資料情況,衍生出了不同的 CV 方法。
- Stratified K-Fold:讓每一折的類別比例盡量接近原始資料。適合分類問題,尤其是類別不平衡時。
- TimeSeriesSplit:適合時間序列資料。訓練時只能使用較早的資料,避免拿未來的資訊預測過去。
- GroupKFold:適合同一個對象有多筆資料的情況,例如同一位病人的多次檢查紀錄。確保同一組不會同時出現在訓練集和驗證集。
- Leave-One-Out(LOO):每次只留一筆資料做驗證。雖然能充分利用資料,但需要訓練很多次,計算成本比較高。
⚠️ 最常見的資料洩漏:在 CV 之前就用全部資料做標準化或特徵選擇。正確做法是用 Pipeline 把前處理和模型包在一起,讓每一折各自 fit(要先切資料,再做資料清理):
pipe = Pipeline([('scaler', StandardScaler()), ('model', LogisticRegression())])
scores = cross_val_score(pipe, X, y, cv=StratifiedKFold(5, shuffle=True, random_state=42))
資料洩漏的影響有時比想像中大。例如在一個純雜訊資料的示範實驗中,先用全部資料選特徵再做 CV,準確率甚至可以達到 0.87;把特徵選擇放進 Pipeline 後,才回到接近隨機猜測的 0.50。實驗見〈sklearn Pipeline 與資料前處理模板〉。
8. 評估指標速查¶
本節為簡單介紹。指標的完整計算、閾值選擇、指標和業務目標怎麼對齊,見〈模型評估與 Cross-Validation 實務〉;PR vs ROC 的取捨與多元分類 OvR/OvO 見〈Géron Ch3〉。
分類:從混淆矩陣出發¶
以法官辦案來說:
- TP:判有罪,實際有罪 → 成功將犯人定罪
- TN:判無罪,實際無罪 → 還好人清白
- FP:判有罪,實際無罪 → 冤獄
- FN:判無罪,實際有罪 → 錯放壞人
從這四格算出常用的指標:
- Accuracy
(TP+TN)/All:判對的比率。(不平衡資料有陷阱,全猜多數類也能高分。例如一種罕見疾病只有 0.01% 的人會得,完全不用看病,直接宣告所有人健康,正確率也有 99.99%。) - Precision
TP/(TP+FP):判有罪的人裡,實際有罪的比例 → 誤報成本高時看(垃圾郵件)。 - Recall
TP/(TP+FN):真正有罪的人裡,被繩之以法的比例 → 漏報成本高時看(癌症篩檢)。 - F1:Precision 和 Recall 的調和平均,兩個都高才會高。
- ROC-AUC:衡量模型能不能把正例排在負例前面。例如預測誰會違約,好的模型應該讓真正會違約的人得到比較高的風險分數。ROC-AUC 越接近 1,代表區分能力越好;0.5 則接近隨機猜測。它不需要先設定分類閾值,但如果正例很少,分數可能看起來不錯,實際卻抓不到多少正例,因此建議搭配 PR-AUC 一起看。
| 情境 | 觀察指標 |
|---|---|
| 平衡資料 | Accuracy |
| 不平衡 | PR-AUC、F1 |
| 漏報成本高(診斷/詐騙) | Recall |
| 誤報成本高(垃圾郵件/推薦) | Precision |
| 排名/機率 | ROC-AUC |
迴歸¶
符號:yᵢ 是實際值,ŷᵢ 是預測值,ȳ 是實際值的平均,n 是筆數。
- MAE
(1/n) Σ |yᵢ − ŷᵢ|:絕對誤差,對離群值不敏感。 - MSE
(1/n) Σ (yᵢ − ŷᵢ)²:平方誤差,重罰離群值,最常拿來當訓練損失。 - RMSE
√MSE:MSE 開根號,單位和 y 一樣,報告最常用。 - R²
1 − Σ(yᵢ − ŷᵢ)² / Σ(yᵢ − ȳ)²:衡量模型相較於直接預測平均值,減少了多少平方誤差。1 代表完美預測,0 代表和預測平均值一樣,負數則表示模型比預測平均值還差。(在含截距的簡單線性迴歸訓練集上,R² 才等於相關係數的平方。) - MAPE(平均絕對百分比誤差)
(100% / n) Σ |(yᵢ − ŷᵢ) / yᵢ|:衡量預測值平均偏離實際值多少百分比。例如 MAPE = 10%,代表平均誤差約為實際值的 10%,容易理解。但當實際值為 0 或接近 0 時,MAPE 會無法計算或變得非常大。
from sklearn.metrics import classification_report, roc_auc_score
print(classification_report(y_true, y_pred))
auc = roc_auc_score(y_true, y_pred_proba)   # 注意要用機率,不是 0/1 預測
常見誤解:AUC 高就代表模型好用
ROC-AUC 量的是排序能力,和閾值無關。但真正上線時一定要選一個閾值,而預設的 0.5 在不平衡資料上幾乎都不對。 實際後果:在正例只佔 4.5% 的資料上,一個邏輯迴歸用 0.5 當閾值,只抓到不到 1 成的正例。開發時看 AUC,部署前要依業務成本另外定閾值(〈常見 ML Case Study〉Case 1 有實測)。
結論¶
機器學習要的,是模型遇到沒看過的資料時,依然能做出好的預測。
模型太簡單,可能抓不到資料中的規律(Underfitting);模型太複雜,又可能把雜訊當成規律記下來(Overfitting)。
這也是為什麼我們需要正則化、Ensemble、Early Stopping 等方法來改善模型的泛化能力,再透過 Cross-Validation 和適合的評估指標,確認模型是不是真的有進步。
實務上不管是換模型、加特徵還是調參數,最後都要回到同一個問題:模型學到的規律,能不能用在沒看過的資料上?
延伸閱讀(本站)¶
- Géron《Hands-On ML》Ch1–9 重點整理 — 按照書籍章節整理,包含 SVM、降維、分群等主題
- 深度學習訓練基礎 — 優化器、Dropout、BatchNorm 的原理與應用
- 特徵工程心法 — 標準化、編碼與特徵選擇的實務細節
- 模型評估與 Cross-Validation 實務 — 交叉驗證、評估指標與常見陷阱
- Gradient Boosting 實戰 — Boosting 模型的實驗與調參
- 統計推論與 A/B 測試 — 假設檢定與實驗設計
- 常見 ML Case Study — 從實際案例理解模型的選擇與評估
參考資料¶
- Géron, A. Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow, 3rd ed.(Ch3 分類、Ch4 訓練與正則化、Ch6–7 決策樹與集成學習)
- Hastie, T., Tibshirani, R. & Friedman, J. The Elements of Statistical Learning, 2nd ed.(Ch3.4 Ridge 與 Lasso、Ch7 模型評估)
- scikit-learn User Guide: Model selection and evaluation
- LightGBM 官方文件:Parameters Tuning
- XGBoost 官方文件:Notes on Parameter Tuning
本頁實驗:Python 3.12、scikit-learn 1.9.1,2026-10-04 執行。多項式實驗訓練 60 筆、驗證 1,000 筆;L1/L2 實驗 200 筆、100 個特徵,種子 0。