PostgreSQL 設計與整合:讓資料庫保護求職助理的資料
摘要
兩個 request 都先查不到 email,再各自 INSERT,仍可能產生重複帳號。API 驗證只能攔住部分錯誤;資料庫約束才是所有寫入者共同遵守的防線。本章把記憶體 API換成 PostgreSQL,保留既有 router、schemas 與 service。
完成後能設計五張表、解釋跨使用者關聯、以參數化 SQL 存取資料,並執行 migration、transaction 與持久化驗收。資料基準:2026-10-22;採 PostgreSQL 17、SQLAlchemy 2.0 Core、psycopg 3 與 Alembic。先在本機備妥 PostgreSQL 17 server 與 psql;若尚未安裝,可先閱讀下一章的 postgres Compose 設定,只啟動該服務,再回本章完成 schema。
先決定資料的意思
這是 OLTP:每個 API 讀寫少量資源,需要約束與交易,而不是以大量彙總查詢為主。PostgreSQL 也可以處理分析工作,OLTP/OLAP 描述的是工作負載,不是互斥的產品分類。
| 關係 | 本系列選擇 |
|---|---|
| users → resumes | 1:N,一人可有多份履歷 |
| resumes → resume_experiences | 1:N,每段經歷一列 |
| users → job_descriptions | 1:N,JD 是使用者私存資料,不是平台共享職缺 |
| resumes ↔ job_descriptions | 經 applications 表達 N:M;申請自己有狀態與分析快照 |
| 同一履歷對同一 JD | 一筆 application;重送回 409 |
| 刪除 user/resume/JD | 有相依資料就 RESTRICT,避免誤刪歷史 |
| 刪除 resume 的經歷 | 經歷跟隨履歷 CASCADE;履歷若已被 application 引用仍不能刪 |
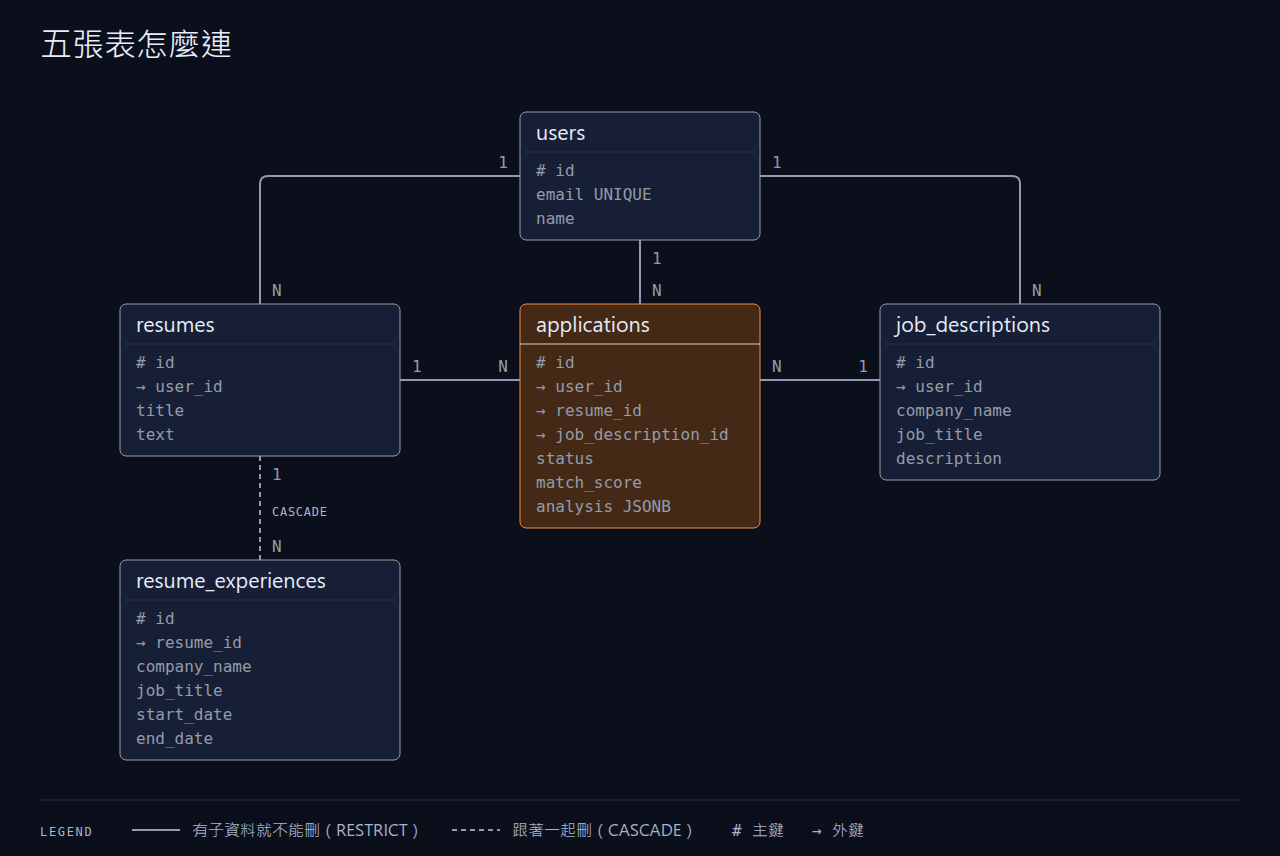
關聯欄位保留明確型別與約束;分析結果的命中、缺漏清單放 JSONB。需要單獨查詢、更新與驗證的工作經歷拆表比較直接;JSONB 也能查詢與建索引,但不會自動提供欄位間的外鍵與文件內部完整性。
我選擇先用 SQLAlchemy Core 的明確 SQL,讓資料庫行為可見;ORM 可以之後加,不必為了換儲存就先重寫 service。若採 ORM,Session 是一次工作單位,不能跨 request 分享;lazy relationship 在迴圈裡可能引發 N+1,應檢查實際 SQL,再依情況用 join 或 selectinload()。
建立資料庫與連線設定
本機管理者以 psql 執行以下指令;密碼由 \password 互動設定,不留在 SQL history。這個教學帳號同時執行 migration 與應用,正式環境宜分離 migration owner 與只具必要 DML 權限的 runtime role。
CREATE ROLE job_assistant LOGIN;
\password job_assistant
CREATE DATABASE job_assistant OWNER job_assistant;
回到練習專案根目錄與 venv:
python -m pip install 'SQLAlchemy>=2.0,<2.1' 'psycopg[binary]>=3,<4' alembic
python -m pip freeze > requirements.txt
export DATABASE_URL='postgresql+psycopg://job_assistant:YOUR_URL_ENCODED_PASSWORD@127.0.0.1:5432/job_assistant'
python -m alembic init migrations
mkdir -p migrations/sql
把密碼替換為自己設定的值;URL 裡的 @、/ 等保留字元要 percent-encode。postgresql+psycopg 選用 psycopg 3,不能混用 psycopg2 的 dependency 名稱。psql 要用一般 postgresql:// URL,不能直接使用 SQLAlchemy dialect 前綴。參考 SQLAlchemy psycopg dialect。
新增 app/database.py:
import os

from sqlalchemy import create_engine


def database_url() -> str:
    url = os.environ["DATABASE_URL"]
    if url.startswith("postgres://"):
        url = "postgresql+psycopg://" + url[len("postgres://"):]
    elif url.startswith("postgresql://"):
        url = "postgresql+psycopg://" + url[len("postgresql://"):]
    if not url.startswith("postgresql+psycopg://"):
        raise RuntimeError("DATABASE_URL must use PostgreSQL with psycopg")
    return url


engine = create_engine(
    database_url(), pool_pre_ping=True, pool_size=5, max_overflow=0,
    pool_timeout=5, connect_args={"connect_timeout": 5},
)
Engine 持有 pool,借出 connection 使用,不是每次 HTTP 都建永久連線。上面的 5 是本範例上限,並非通用最佳值;多 process 或多 instance 時各自都有 pool,要用「instance 數 × worker 數 × 每 pool 上限」估總量,再預留 migration 與管理連線。pre_ping 檢查借出時的連線存活,不會讓執行中失敗的 transaction 自動重試。
第一份 schema:可直接執行的 SQL
新增 migrations/sql/0001_initial.sql。這是第一版 migration 的固定輸入;部署過後不再修改它,後續變更另寫 revision。
CREATE TABLE users (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email TEXT NOT NULL,
    name TEXT NOT NULL CHECK (length(btrim(name)) BETWEEN 1 AND 200),
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    CONSTRAINT users_email_canonical CHECK (
        email = lower(btrim(email)) AND email <> ''
    ),
    CONSTRAINT users_email_key UNIQUE (email)
);

CREATE TABLE resumes (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    user_id BIGINT NOT NULL REFERENCES users(id) ON DELETE RESTRICT,
    title TEXT NOT NULL CHECK (length(btrim(title)) BETWEEN 1 AND 200),
    text TEXT NOT NULL CHECK (length(btrim(text)) BETWEEN 1 AND 20000),
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    CONSTRAINT resumes_owner_key UNIQUE (user_id, id)
);

CREATE TABLE resume_experiences (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    resume_id BIGINT NOT NULL REFERENCES resumes(id) ON DELETE CASCADE,
    company_name TEXT NOT NULL CHECK (btrim(company_name) <> ''),
    job_title TEXT NOT NULL CHECK (btrim(job_title) <> ''),
    start_date DATE NOT NULL,
    end_date DATE,
    description TEXT NOT NULL DEFAULT '',
    CHECK (end_date IS NULL OR end_date >= start_date)
);
CREATE INDEX resume_experiences_resume_idx ON resume_experiences (resume_id);

CREATE TABLE job_descriptions (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    user_id BIGINT NOT NULL REFERENCES users(id) ON DELETE RESTRICT,
    company_name TEXT NOT NULL CHECK (length(btrim(company_name)) BETWEEN 1 AND 200),
    job_title TEXT NOT NULL CHECK (length(btrim(job_title)) BETWEEN 1 AND 200),
    description TEXT NOT NULL CHECK (length(btrim(description)) BETWEEN 1 AND 20000),
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    CONSTRAINT jobs_owner_key UNIQUE (user_id, id)
);

CREATE TABLE applications (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    user_id BIGINT NOT NULL REFERENCES users(id) ON DELETE RESTRICT,
    resume_id BIGINT NOT NULL,
    job_description_id BIGINT NOT NULL,
    status TEXT NOT NULL DEFAULT 'draft'
        CHECK (status IN ('draft', 'submitted', 'rejected', 'accepted')),
    match_score DOUBLE PRECISION NOT NULL CHECK (match_score BETWEEN 0 AND 100),
    analysis JSONB NOT NULL CHECK (jsonb_typeof(analysis) = 'object'),
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    CONSTRAINT applications_resume_owner_fk FOREIGN KEY (user_id, resume_id)
        REFERENCES resumes(user_id, id) ON DELETE RESTRICT,
    CONSTRAINT applications_job_owner_fk FOREIGN KEY (user_id, job_description_id)
        REFERENCES job_descriptions(user_id, id) ON DELETE RESTRICT,
    CONSTRAINT applications_once_key UNIQUE (user_id, resume_id, job_description_id)
);
CREATE INDEX applications_user_created_idx
    ON applications (user_id, created_at DESC, id DESC);
CREATE INDEX applications_job_idx ON applications (user_id, job_description_id);
PRIMARY KEY 同時保證唯一與非 NULL;identity 產生 ID,但不保證連號。NOT NULL 不會拒絕空字串,所以另加 CHECK。TIMESTAMPTZ 保存時間點,顯示時依 session 時區轉換,不會保留原始輸入的時區名稱。
本產品把 email 全部轉成小寫再儲存,作為帳號識別政策。一般 TEXT UNIQUE 不等於忽略大小寫;service 正規化加上 DB 的 canonical CHECK,讓直接 SQL 也不能偷偷塞入另一種大小寫。這不是宣稱所有郵件服務都用相同語意;郵件格式仍由 API 驗證。
若只分別驗證 user_id、resume_id、job_description_id 存在,仍可能把甲的履歷接到乙的申請。兩個複合 FK 保證引用者與所有者一致;對應的 (user_id, id) UNIQUE 是複合 FK 可參照的鍵。參考 PostgreSQL constraints。
PK/UNIQUE 會自動建索引,FK 的引用端不會自動建索引。resumes、job_descriptions 的複合鍵已支援以 user_id 為前綴查詢;applications 的 created index 支援某位 user 的時間排序。applications_once_key 已涵蓋 (user_id, resume_id) 前綴,不再替相同前綴建立重複 index。索引會增加寫入與儲存成本,應依查詢與刪除模式決定。
Alembic 記錄 schema 版本
替換產生的 migrations/env.py,不把秘密寫進 alembic.ini:
from alembic import context
from sqlalchemy import create_engine, pool

from app.database import database_url


def run_migrations_offline():
    context.configure(url=database_url(), literal_binds=True)
    with context.begin_transaction():
        context.run_migrations()


def run_migrations_online():
    connectable = create_engine(database_url(), poolclass=pool.NullPool)
    with connectable.connect() as connection:
        context.configure(connection=connection)
        with context.begin_transaction():
            context.run_migrations()
    connectable.dispose()


if context.is_offline_mode():
    run_migrations_offline()
else:
    run_migrations_online()
新增 migrations/versions/0001_initial.py:
from pathlib import Path

from alembic import op

revision = "0001"
down_revision = None
branch_labels = None
depends_on = None


def upgrade():
    path = Path(__file__).resolve().parents[1] / "sql" / "0001_initial.sql"
    for statement in path.read_text(encoding="utf-8").split(";"):
        if statement.strip():
            op.execute(statement)


def downgrade():
    raise RuntimeError("initial schema removal requires an explicit data recovery plan")
這個 split 只適用於上面的簡單 DDL;含函式本體或字串內分號的 migration 要用明確的 op.execute(),不能沿用簡單切割器。執行:
預期 current 顯示 0001 (head),第二次 upgrade 沒有額外建表。migration 與 SQL 一起進版控;不是每次啟動 API 就呼叫 create_all()。本系列的初始版本不提供刪表 downgrade,部署回復會保留資料,見部署章。
PostgreSQL repository:沿用第三章介面
新增 app/postgres_repository.py:
from sqlalchemy import bindparam, text
from sqlalchemy.dialects.postgresql import JSONB

COLUMNS = {
    "users": ("email", "name"),
    "resumes": ("user_id", "title", "text"),
    "job_descriptions": ("user_id", "company_name", "job_title", "description"),
    "applications": (
        "user_id", "resume_id", "job_description_id", "status", "match_score", "analysis"
    ),
}


class PostgresRepository:
    def __init__(self, connection):
        self.connection = connection

    def create(self, table: str, data: dict) -> dict:
        columns = COLUMNS[table]
        if set(data) != set(columns):
            raise ValueError("unexpected insert columns")
        names = ", ".join(columns)
        placeholders = ", ".join(f":{name}" for name in columns)
        statement = text(f"INSERT INTO {table} ({names}) VALUES ({placeholders}) RETURNING *")
        if table == "applications":
            statement = statement.bindparams(bindparam("analysis", type_=JSONB))
        return dict(self.connection.execute(statement, data).mappings().one())

    def get(self, table: str, record_id: int) -> dict | None:
        if table not in COLUMNS:
            raise ValueError("unknown table")
        statement = text(f"SELECT * FROM {table} WHERE id = :id")
        row = self.connection.execute(statement, {"id": record_id}).mappings().one_or_none()
        return dict(row) if row else None

    def list_resumes(self, user_id: int, limit: int) -> list[dict]:
        statement = text("""
            SELECT * FROM resumes WHERE user_id = :user_id ORDER BY id LIMIT :limit
        """)
        return [dict(row) for row in self.connection.execute(
            statement, {"user_id": user_id, "limit": limit}
        ).mappings()]

    def patch_resume(self, record_id: int, changes: dict) -> dict | None:
        if not changes or not set(changes) <= {"title", "text"}:
            raise ValueError("invalid patch columns")
        setters = ", ".join(f"{key} = :{key}" for key in changes)
        statement = text(f"UPDATE resumes SET {setters} WHERE id = :id RETURNING *")
        row = self.connection.execute(
            statement, {**changes, "id": record_id}
        ).mappings().one_or_none()
        return dict(row) if row else None
值用 bind parameter 傳入,不能用 f-string 拼使用者文字。表名與欄位名無法當作一般值參數綁定,這裡只從程式內固定 allowlist 選取;request 不接受任意 table 或 column。分析 dict 以 JSONB 型別綁定,不把 JSON 字串手動插進 SQL。
在 app/dependencies.py 保留第三章的 require_api_key 與 bearer,移除 memory 的 import/實例,將 get_repository() 替換成以下版本,並補上列出的 import:
import logging

from sqlalchemy.exc import IntegrityError, InterfaceError, OperationalError, TimeoutError

from app.database import engine
from app.errors import Conflict, DomainError, Unavailable
from app.postgres_repository import PostgresRepository

logger = logging.getLogger(__name__)


def get_repository():
    try:
        with engine.begin() as connection:
            yield PostgresRepository(connection)
    except IntegrityError as exc:
        code = getattr(exc.orig, "sqlstate", None)
        if code == "23505":
            raise Conflict("email or application already exists") from exc
        if code == "23503":
            raise Conflict("related record changed or is still referenced") from exc
        if code in {"23502", "23514"}:
            raise DomainError("record violates a database constraint") from exc
        raise
    except (OperationalError, InterfaceError, TimeoutError) as exc:
        logger.error("database operation failed sqlstate=%s", getattr(getattr(exc, "orig", None), "sqlstate", None))
        raise Unavailable("database temporarily unavailable") from exc
在 app/routers/api.py 的 get_service() 把 repository 依賴改成 Depends(get_repository, scope="function")。這讓 yield dependency 在 endpoint 完成後、HTTP response 送出前結束:commit 如果失敗,仍能回傳錯誤,不能先送 201 再發現資料沒存下來。可先用 python -c 'import inspect; from fastapi import Depends; assert "scope" in inspect.signature(Depends).parameters' 確認安裝版本支援;參考 Dependencies with yield。
engine.begin() 成功就 commit,有例外就 rollback。一次 endpoint 的 service 查詢與寫入共用同一連線。獨立 engine/connection 不能以這種方式拼成同一 transaction。IntegrityError 要在 rollback 後轉成業務錯誤;若使用 ORM Session,flush 失敗後也必須 rollback 才能重用。
在 app/main.py 加入以下 import 與 route,保留其他程式:
from sqlalchemy import text
from sqlalchemy.exc import SQLAlchemyError

from app.database import engine


@app.get("/ready")
def readiness():
    try:
        with engine.connect() as connection:
            connection.execute(text("SELECT 1"))
        return {"status": "ready"}
    except SQLAlchemyError:
        return JSONResponse(status_code=503, content={"status": "unavailable"})
/health 表示程序能處理 HTTP,/ready 檢查 DB 連通性。SELECT 1 不驗證資料表版本,因此還要另外驗證 migration 與真實寫讀流程。若要限制慢 SQL,可對 runtime role/DB 設定符合服務需求的 statement_timeout;連線 timeout 不是 SQL 執行 timeout。
實作驗收:持久化、競爭與交易
先停止第三章程序,確認 APP_API_KEY、DATABASE_URL 都存在,再啟動:
用上一章的 curl 重建 user、resume、job、application,記下實際 ID。關閉並重開 Uvicorn,再 GET /applications/{id};預期仍有原分數。第三章的六個 pytest 仍使用 override 的記憶體 repository,能檢查 API 契約,但不能取代 PostgreSQL 整合驗收。
在 psql 連到教學資料庫後,檢查交易與經歷表。把 :resume_id 設為自己已建立的履歷 ID:
\set resume_id 1
BEGIN;
INSERT INTO resume_experiences (resume_id, company_name, job_title, start_date)
VALUES (:resume_id, 'Example', 'Analyst', DATE '2024-01-01');
ROLLBACK;
SELECT count(*) FROM resume_experiences WHERE resume_id = :resume_id;
全新資料庫預期 count 為 0。ACID 在這裡可具體理解為:多個 SQL 一起成功或回復(atomicity)、約束維持有效狀態(consistency)、並行交易依隔離規則互動(isolation)、成功提交後依資料庫耐久性設定保存(durability)。隔離不代表所有請求自動串行。
用兩個 psql session 對相同、尚不存在的 email 做 INSERT:A BEGIN 後 INSERT 尚不提交,B INSERT 相同 email 會等待;A COMMIT 後 B 得到 unique violation。若 A ROLLBACK,B 可以成功。這正是先 SELECT 不足、需要 UNIQUE 的原因;也可用 INSERT ... ON CONFLICT 設計明確的冪等行為。參考 PostgreSQL unique indexes 與併發。
查詢計畫練習:
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM applications
WHERE user_id = 1 ORDER BY created_at DESC, id DESC LIMIT 20;
小表選 sequential scan 可能合理;不能以「一定出現 Index Scan」判定通過。ANALYZE 會真的執行 SQL,寫入查詢需特別留意副作用。這裡只觀察 SELECT 的估計列數、實際列數、排序與 buffer 使用。
並行更新的限制
本版 PATCH 採最後寫入者覆蓋同欄位;不同欄位因只更新提供的欄位而可各自保留。建立 application 時 PostgreSQL 預設 Read Committed,每條 statement 看到的快照可能不同。若同時改履歷,分析可能基於修改前的文字;儲存的結果是當時計算結果,並不保證能從目前履歷重建。
需要精確稽核時,下一步應把 resume/JD 做不可變版本,application 引用版本;或在同一 transaction 以固定順序 SELECT ... FOR UPDATE 鎖定相關資料,再計算與插入。樂觀鎖則需版本欄位與 UPDATE ... WHERE version = :expected,零列更新時回衝突。這些是不同產品契約,不能只提高隔離級別就宣稱消除所有競爭。完整交易重試也只能在操作可安全重做、尚未寄信或收費時採用。
常見錯誤與自我檢核
- [ ] Schema 題:以直接 SQL 插入甲 user、乙 resume 的 application。預期複合 FK 拒絕,不能只靠 API service。
- [ ] Bug 題:並行建立相同 email。預期最多一筆成功,API 將另一筆轉成 409,不回傳 DB 內部 SQL。
- [ ] SQL 題:經歷的結束日期早於開始日期。預期 CHECK 拒絕;NULL 結束日期可代表仍在職。
- [ ] 效能題:說出為何 PK/UNIQUE 不需再建相同 index,以及小表為何可能不用 index。
- [ ] 實作題:
alembic upgrade head重跑、API 重啟後讀取。預期 revision 不變、資料仍在。 - [ ] 邊界題:刪除已有履歷的 user。預期 RESTRICT;要真正刪除個資時,另訂經授權的清理、留存與備份政策。
下一步:Docker 化。
參考與來源
- 原始家教對話:設計 PostgreSQL(chat1,整理於 2026-10-22);補齊五表 DDL、關聯答案、實際 migration 與儲存替換。
- PostgreSQL 17:Constraints
- PostgreSQL 17:Transaction Isolation
- PostgreSQL 17:Date/Time Types
- SQLAlchemy 2.0:Transactions
- SQLAlchemy 2.0:Connection Pooling
- Alembic Tutorial