project-inventory:一頁看完所有專案的 Claude Code skill
摘要
同時跑七八個專案時,最常問自己的是:哪個 PR 還沒合併?哪份資料停了沒人發現?上個月那個專案到底做到哪?答案散在 Linear、Notion、GitHub、本機資料夾和資料檔裡,每次都要一個一個打開看。
project-inventory 是一個 Claude Code skill。跟 Claude 說「幫我盤點專案」,它會把這些地方全部讀一遍,做成一個 HTML 檔:首頁列出所有在等你處理的事,每個專案有運作流程圖、待辦、每週進度和基本資料。
它從我自己用的專案拆機台抽出來,改成別人也能裝的通用版(2026-10-02 起)。本文記錄它怎麼分工:能用腳本算出來的都交給腳本,Claude 只做需要判斷的部分。
示範畫面
下面的截圖是用兩個公開 repo(本專案和 CVS Radar)做的示範頁,資料基準 2026-10-03。
主要畫面
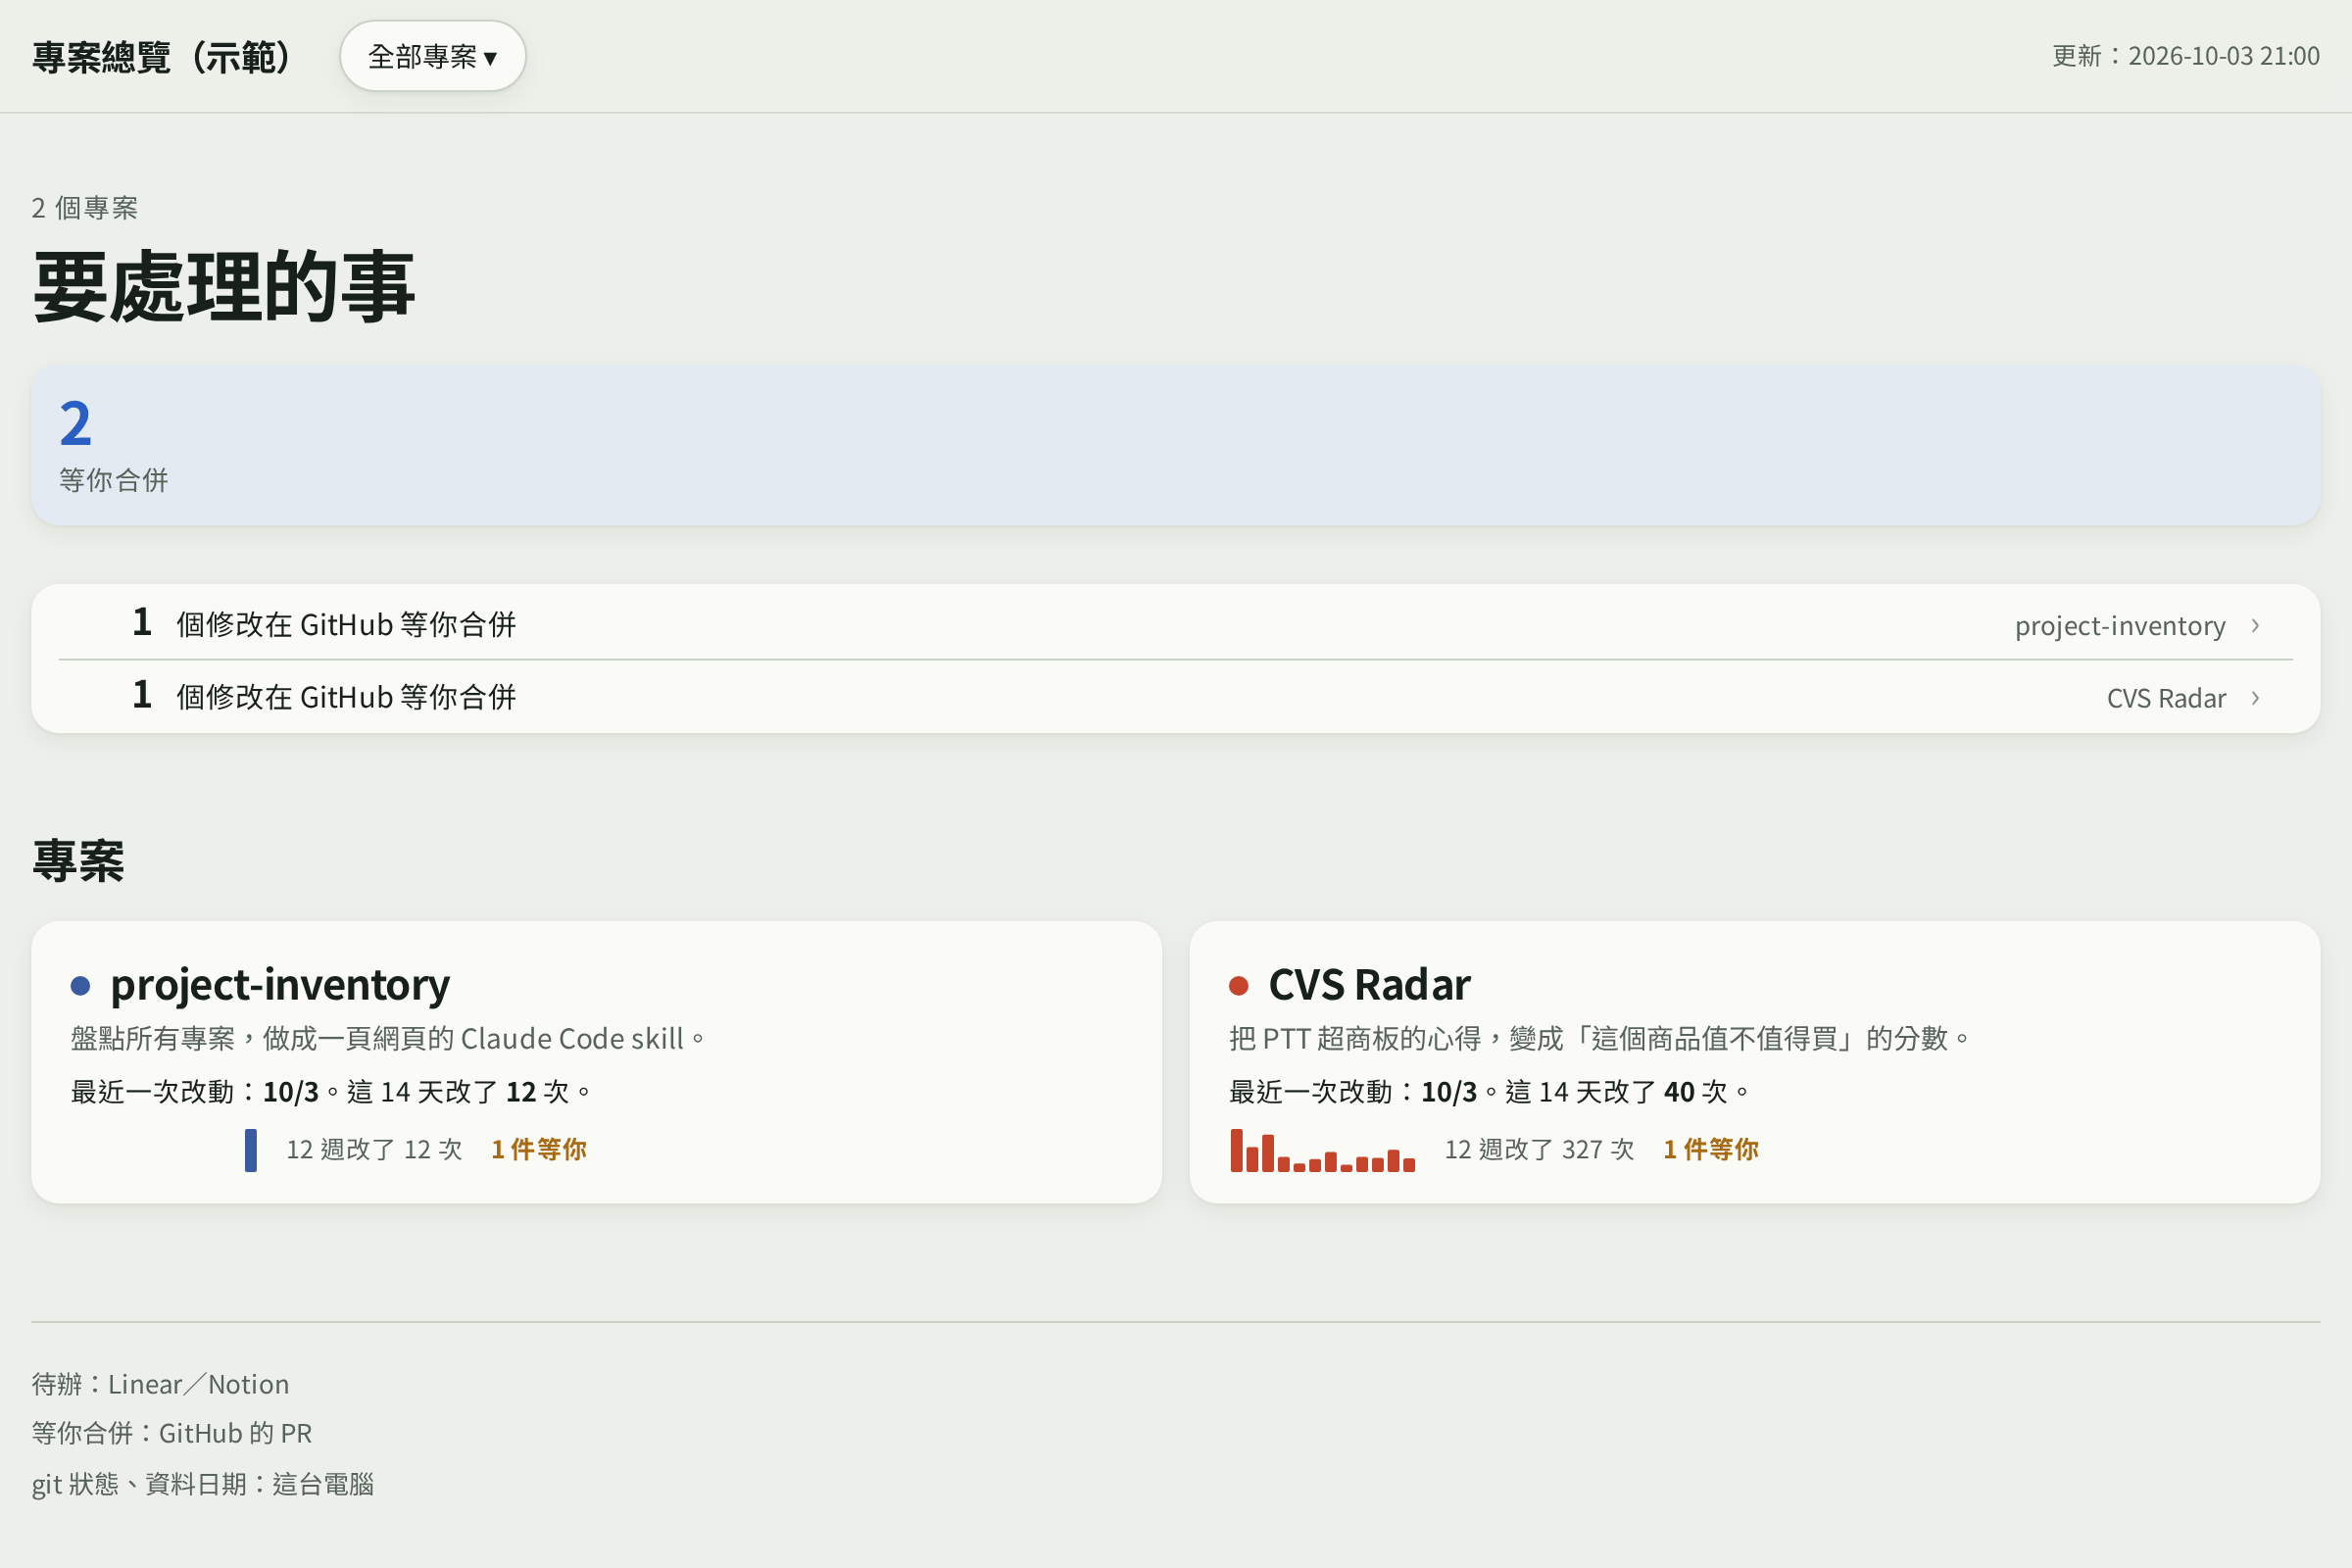
首頁:要處理的事。 最上面是分類加總,下面是一列一件事:哪個專案有 PR 等你合併、哪個資料夾有改到一半沒存的檔、哪份資料過期了。點一列會跳到那個專案對應的分頁。
運作流程。 中間由上往下是主要步驟,兩邊是支線。方塊點開可以看說明、截圖、公式,或「進去什麼、出來什麼」的示意。下圖是這個 skill 自己的流程:
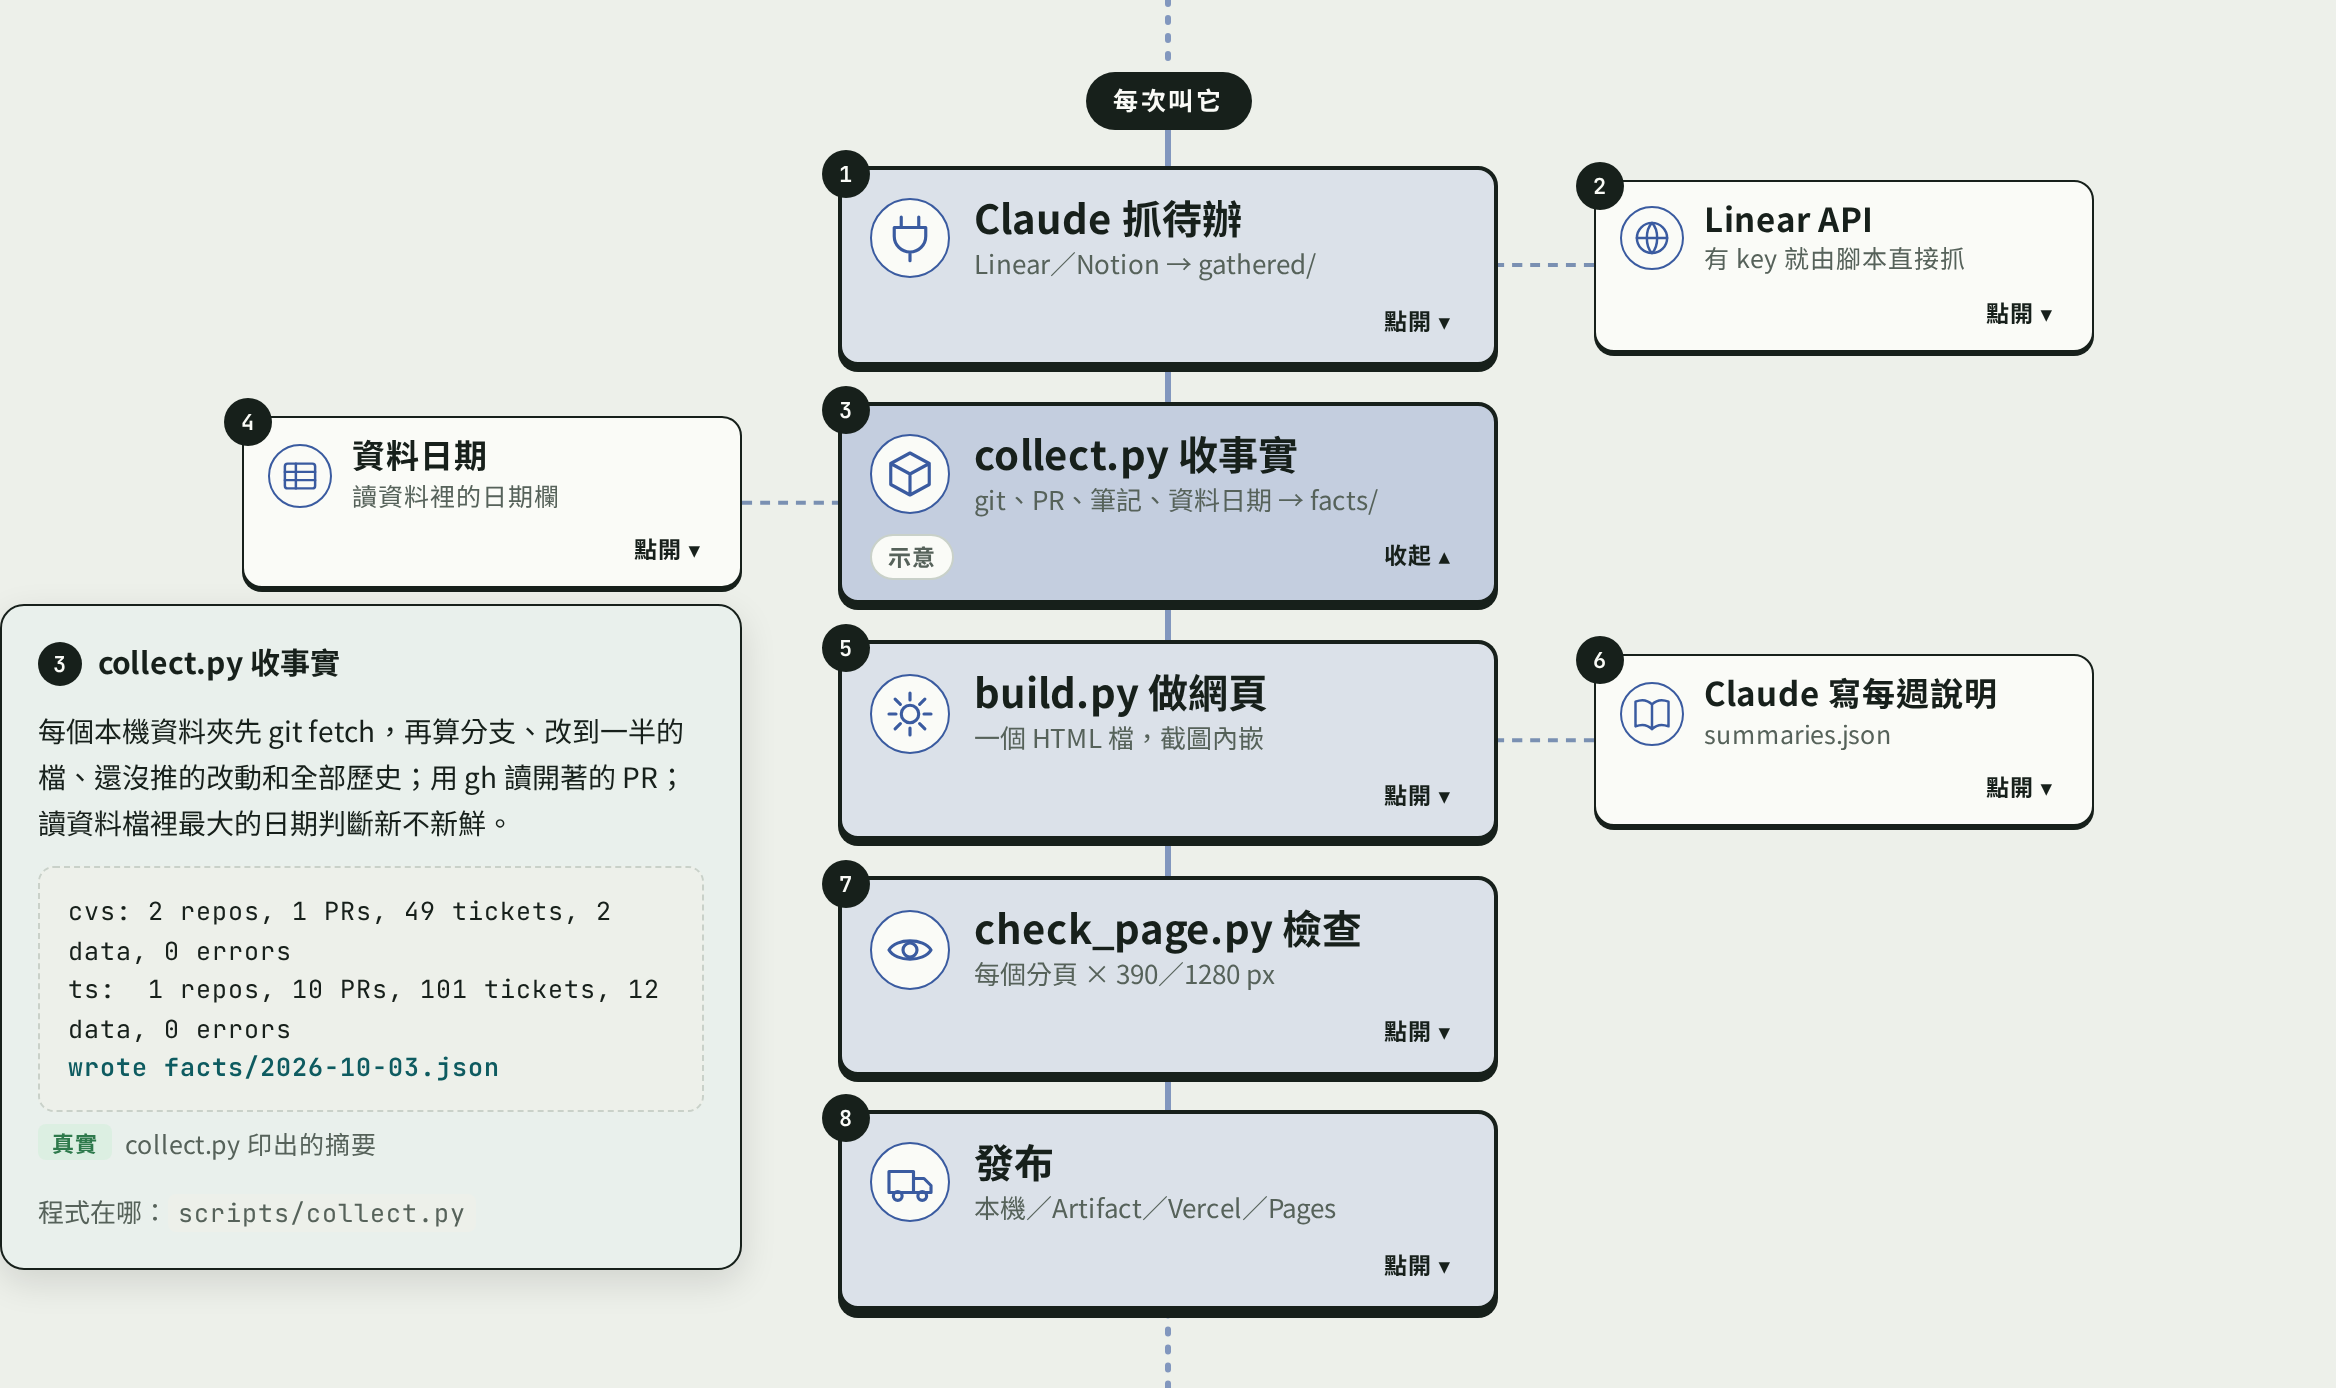
流程圖是 Claude 讀程式碼和 README 後畫的草稿,使用者確認過才存。說明裡的事實要對得上程式碼,對不上就改。
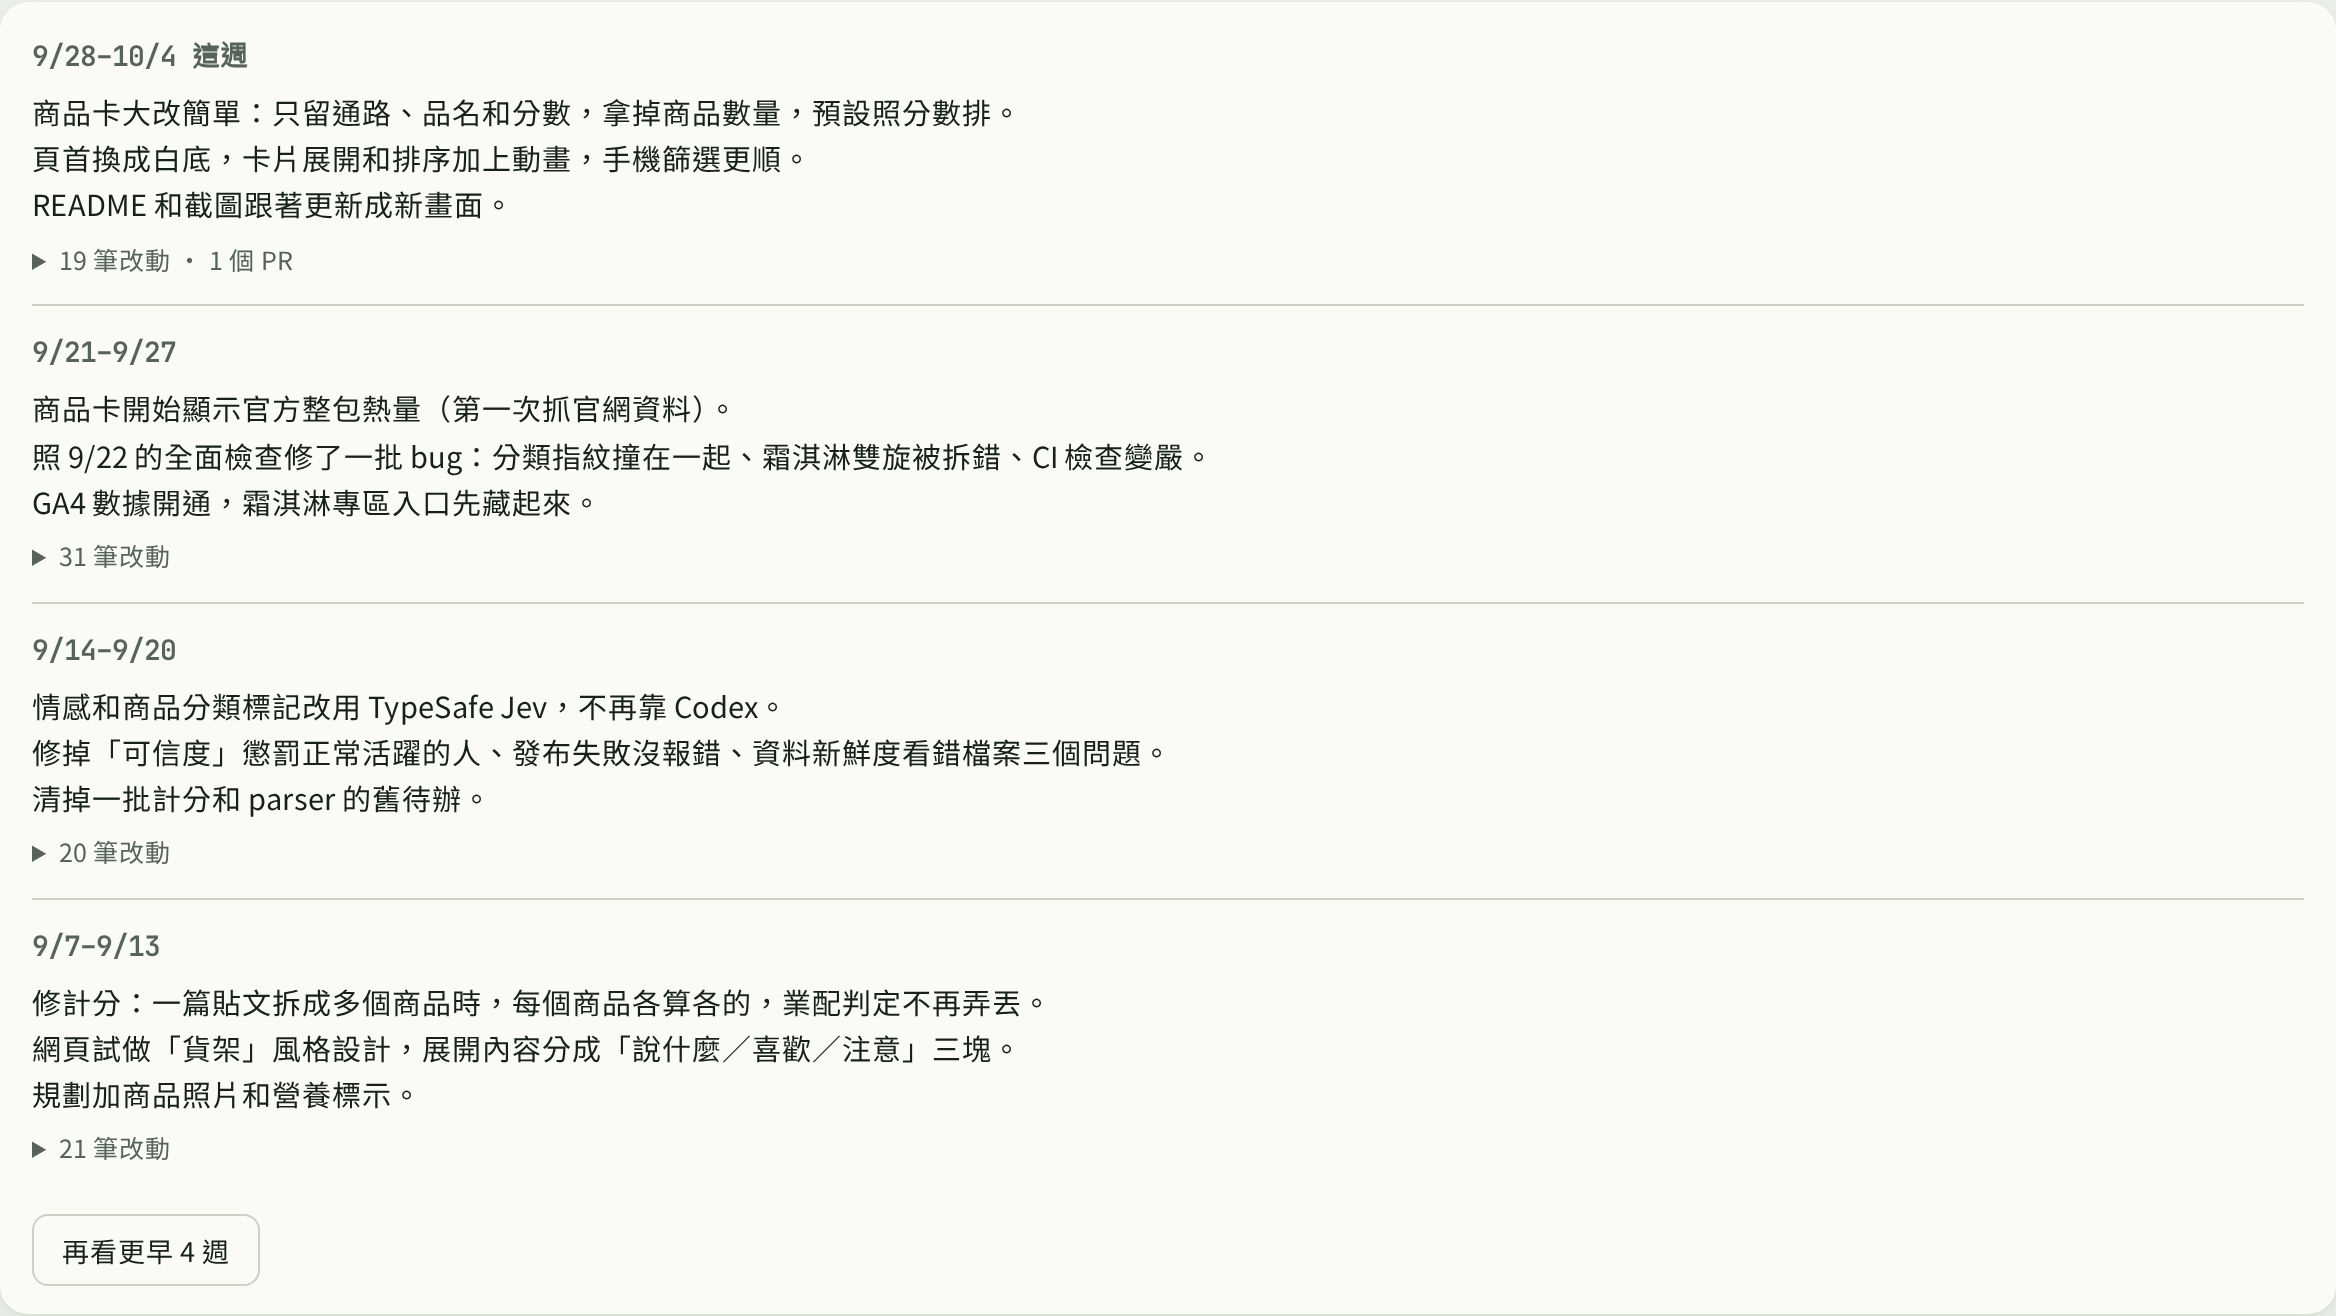
每週進度。 從第一筆紀錄到現在,一週一組。每週有 2–3 句白話說明,點開才是那週每一筆 commit、做完的待辦和新開的 PR。先列 4 週,按鈕每次多 4 週。
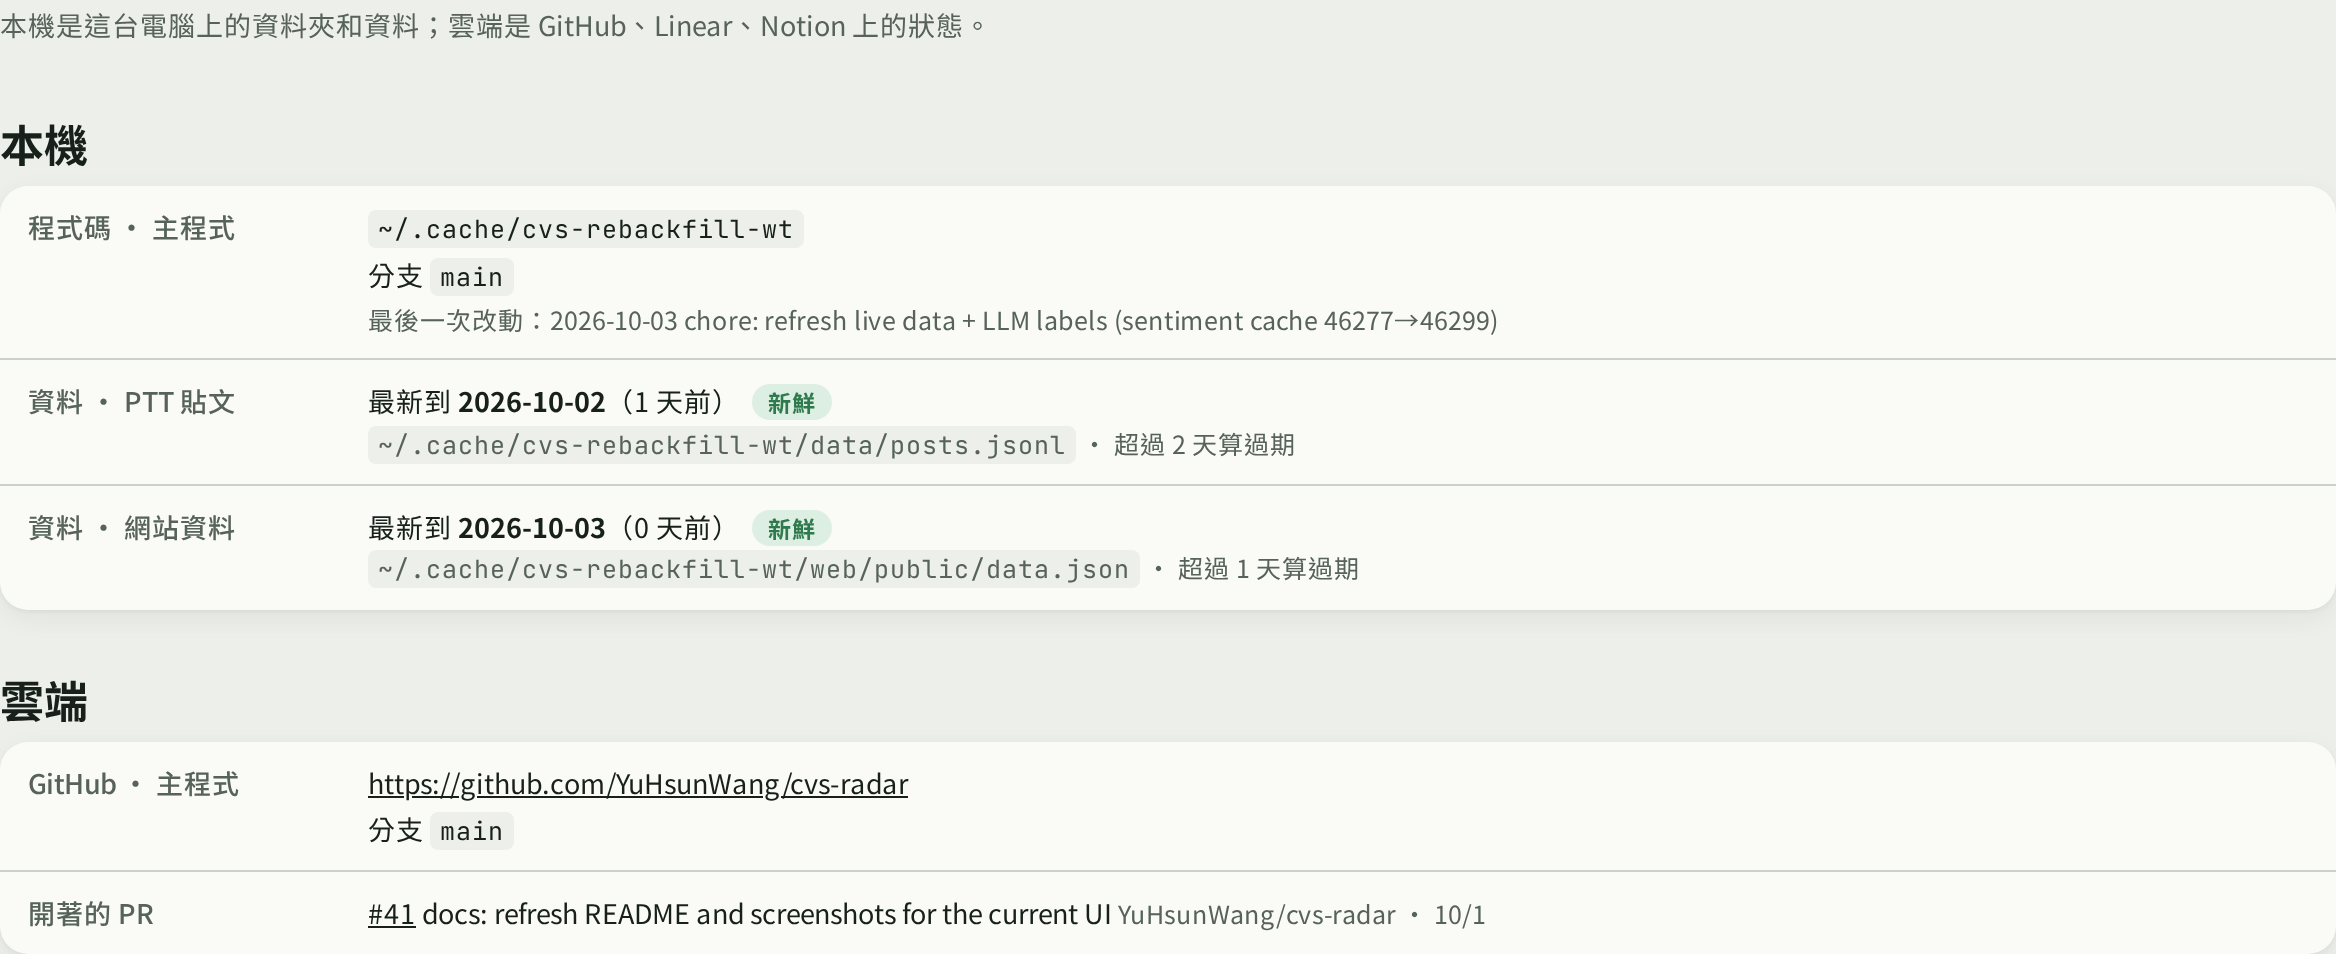
基本資料。 分成本機和雲端兩張表。本機是資料夾、分支、改到一半的檔、資料日期;雲端是 GitHub 網址、還沒推的改動、開著的 PR、Linear 專案、Notion 頁面。
誰做什麼:腳本 vs Claude
這個 skill 最主要的設計是分工。原則只有一條:答案是確定的,就寫腳本;要判斷的,才交給 Claude。
| 工作 | 誰做 | 為什麼 |
|---|---|---|
| git 分支、改到一半的檔、還沒推的改動、全部歷史 | collect.py |
git 指令的輸出就是答案 |
| 開著的 PR | collect.py(gh) |
同上 |
| Linear 待辦 | 有 LINEAR_API_KEY 時 collect.py 直接打 API;沒有才由 Claude 透過 MCP 抓 |
腳本比較快,數字也一定一樣 |
| Notion 待辦 | Claude(MCP) | 沒有穩定的腳本接法 |
| 資料新不新鮮 | collect.py |
讀資料裡最大的日期,跟今天比 |
| 做網頁 | build.py |
純粹的資料轉換 |
| 檢查網頁 | check_page.py(無頭瀏覽器) |
每個分頁 × 手機 390 px、桌機 1280 px,點開每個方塊 |
| 流程圖、每週說明、待辦的「做完有什麼用」 | Claude | 要讀懂程式碼和 commit 才寫得出來 |
這樣分有兩個好處。第一,腳本不靠 Claude 也能跑:用 cron 每天跑 collect.py 和 build.py,網頁照樣更新,只是 Notion 和新的週說明要等下次叫 Claude。第二,Claude 寫的東西範圍很小,容易檢查。
一個實際踩到的坑:collect.py 只要有來源沒讀到(例如 cron 跑時沒人去抓 Notion)就回傳 1。如果排程寫 collect.py && build.py,網頁就永遠不會更新。要用 ; 接。
資料新不新鮮:讀資料裡的日期,不看檔案時間
判斷「資料是不是停了」最直覺的做法是看檔案修改時間,但這不準:複製、重建、git checkout 都會把修改時間改成現在,停了三天的資料看起來還是今天的。
所以設定時,Claude 會在每份資料裡找日期欄位,collect.py 每次讀那一欄的最大值。支援 csv、jsonl、json(指定欄位路徑)、sqlite、parquet(可以是整個資料夾)、duckdb。每份資料各自設幾天算過期。
常見誤解/釐清
誤解: 檔案今天有被寫過,資料就是新的。
更正: 排程可能每天都跑、每天都重寫檔案,但抓回來的內容是舊的(來源掛了、只抓到快取)。只有資料本身的日期能說明它新不新鮮。
後果: 看修改時間的檢查,在最需要它的時候(來源默默壞掉)剛好不會報警。
每週說明怎麼知道要不要重寫
每週說明是 Claude 寫的,寫一次要讀完那週所有 commit,不便宜。所以寫過的週不重寫,只有兩種情況要寫:
- 這週還沒有說明(第一次跑時就是以前的每一週)。
- 這週在寫完說明之後又多了新的改動。
第二種用一個數字判斷:存說明時一起記下「寫的時候這週有幾筆」(n)。build.py 每次重算筆數,跟 n 不一樣就把這週列進 summaries-needed.json,Claude 照清單補寫。平常只有「這週」會一直變,過完的週筆數不會再動,自然不會被重寫。
說明只能根據那週列出來的 commit、待辦和 PR 寫,不能自己補沒寫在上面的事。
待辦趨勢第一次就畫得出來
「待辦數量變化」常見的做法是每天存一次快照,然後畫快照。缺點是第一次跑時只有一個點,要等好幾週才看得出趨勢。
這裡改成用每張待辦自己的三個日期倒推:建立日、完成日、取消日。任何一天「還沒做完的」= 那天以前建立、而且那天還沒完成也沒取消的。這樣第一次跑就有近 90 天的完整曲線。
網頁放哪裡
網頁上有專案名稱、待辦、分支、檔案路徑,所以預設只存成本機檔案。另外三種要使用者自己選:
| 選項 | 誰看得到 |
|---|---|
| 本機檔案(預設) | 只有這台電腦 |
| claude.ai Artifact | 只有自己 |
| Vercel | 只有登入自己 Vercel 帳號的人 |
| GitHub Pages | 所有人(免費方案就算 repo 是私人的也一樣),第一次發布前會先問 |
Vercel 的發布腳本做三件事:先開啟保護再部署(反過來的話,部署完到開保護之間會有一段時間是公開的);不會覆蓋不是它建的 Vercel 專案,避免名字打錯蓋掉別的網站;部署完用沒登入的身分打開每個網址,必須被擋下(401、403 或轉去登入頁)才算成功。
GitHub 的網址存進資料前,會先拿掉 https://帳號:token@ 這種寫在網址裡的帳密,免得 token 跟著網頁被發布出去。
怎麼裝
在 Claude Code 裡:
/plugin marketplace add YuHsunWang/project-inventory
/plugin install project-inventory@project-inventory
然後說「幫我盤點專案」。第一次會一題一題問:要放哪些專案、各自連到哪、要盯哪些資料、流程圖對不對。設定存在 ~/.project-inventory/inventory.json。
不需要 MCP server。skill 就是一個資料夾(SKILL.md 寫步驟,scripts/ 是只用 Python 標準庫的腳本),所以 Codex 這類讀同樣格式的工具,把資料夾複製進去也能用。
技術棧
| 部分 | 用什麼 |
|---|---|
| 收資料 | Python 標準庫、git、gh;Linear GraphQL API |
| parquet/duckdb 資料檢查 | duckdb(只有用到才要裝) |
| 網頁 | 單一 HTML 檔,資料和截圖都內嵌(截圖轉 data URI);有公式的頁面才載 MathJax |
| 圖表 | 手寫 SVG,沒有圖表套件 |
| 網頁檢查 | Playwright(Chromium 無頭模式) |
| 測試 | 一支 tests/test_scripts.py,只用標準庫,不連網 |
還沒做完的
- GitHub Pages 發布、Notion 待辦還沒實際跑過。 步驟寫在
SKILL.md裡,但到 2026-10-03 為止沒有在真的帳號上驗證。 - Hermes 沒試過。 Codex 試過:它自己找到 skill 資料夾,跑完整個盤點。
- 第一次跑要補完以前每一週的說明,專案歷史長的話會很久。
延伸閱讀(本站)
- CVS Radar:超商商品評價雷達 — 示範畫面裡的另一個專案
來源
- project-inventory repository(README、
說明書.md、skills/project-inventory/reference/schema.md)