從分析師走到資料工程師的水管地圖
資料基準與作者
Oct 11, 2026 · @Shane
摘要
2025–2026 年各大學習路線的順序大致相同:先把 SQL 和 Python 練到工程等級,接著學資料建模(Kimball 的 fact/dimension 與 grain),然後自己做一條完整的 batch pipeline(ingest → raw → staging → mart,加上排程和資料品質檢查),再進到 Docker、雲端和 CI/CD。Spark、Kafka 串流和 Iceberg 這類 Lakehouse 技術放在最後,等真的碰到需要時再學 (DataTalks.Club podwiki)。
已經會寫程式的人,專心投入大約 3–6 個月可以走完主線;從零開始、利用下班時間學,則要 12–18 個月 (Analytics Vidhya; Data with Baraa)。對已經熟悉 Python、SQL 和 Power BI 的零售資料分析師來說,SQL 入門、star schema 概念和商業領域知識都可以直接跳過。真正要補的是工程習慣:Git、CLI、Docker、可上線的 Python、測試,以及 idempotent(可重跑)的寫入方式。
2026 年工具版圖洗牌得很厲害:Fivetran 和 dbt Labs 在 6 月完成合併,IBM 在 3 月買下 Confluent,Iceberg 也成了四大平台都支援的開放表格格式 (Fivetran; StockTitan / IBM; Data Lakehouse Hub)。所以學概念比背工具重要。上線之後最常讓人頭痛的也不是技術難題,而是靜悄悄的資料錯誤、重跑導致的重複資料、指標定義吵不完,還有沒人負責的告警。
延伸閱讀:DA 轉 DS 學習地圖:要補的是機器學習和工程。
學習地圖總覽:五個階段,一條水管
用五歲小孩聽得懂的話說:資料工程師就是蓋水管的人。 每家店、每台收銀機、每個 App 都是一口井,水(資料)從這裡冒出來,有的乾淨,有的混了泥沙,有時候還會晚到。資料工程師負責把水管接到每口井,把水引進水庫存好,用濾網過濾乾淨,再按時把水送到每個需要的人家裡:老闆的報表、分析師的 Power BI、AI 模型。水管破了要有警報,水髒了要在進門前攔下來,水費(雲端費用)也不能失控。
Reis 和 Housley 把這條流程整理成 Generate、Store、Ingest、Transform、Serve 五步,再加上安全、資料管理、DataOps、架構、排程和軟體工程六條「暗流」。Reis 在 2026 年回顧時說,這個框架四年後依然成立,因為它講的是抽象概念而不是工具清單;他也認為成本(FinOps)可能該列為第七條暗流 (Joe Reis 2026)。
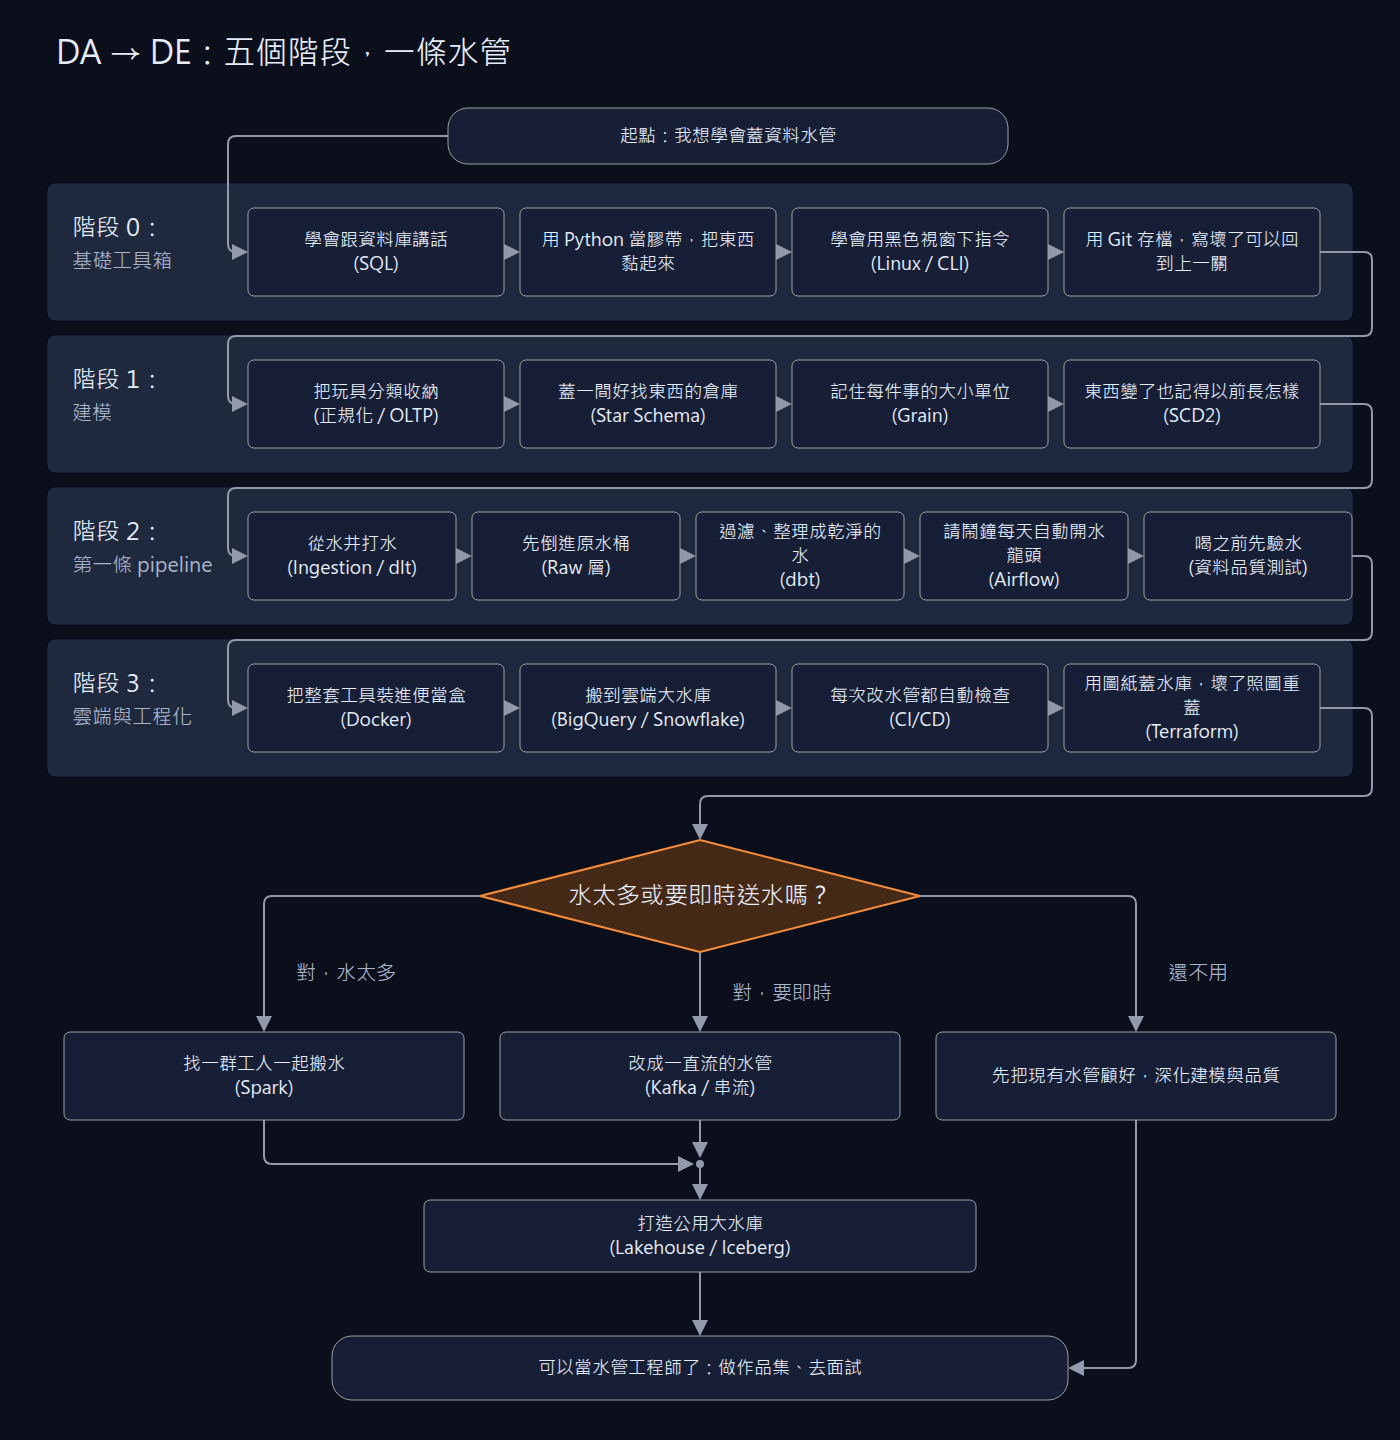
這張圖的順序和 DataTalks.Club、Analytics Vidhya 與 DataExpert.io 的課綱一致。最後一關畫成岔路,因為 podwiki 明白寫著 Spark、Kafka、Kubernetes、Iceberg 這類進階工具要「等限制出現才學」(podwiki)。
有個常見的過時建議是先學 Hadoop。現在主流課綱(Zoomcamp、DataExpert、podwiki)都已經沒有 Hadoop 或 MapReduce 單元,Analytics Vidhya 也只建議知道 HDFS、YARN、MapReduce 當初是為了解決什麼問題就好 (Analytics Vidhya; Zoomcamp)。
學習手冊:每一關學什麼、怎樣算過關
以下時間以每週約 10 小時估算,參考 podwiki 的 12 週節奏和 Analytics Vidhya 的 6 個月計畫,再依讀者背景調整。這些是推估值;podwiki 也提醒自己的 12 週「不是保證」,會 SQL 和 Python 的人可以走得更快 (podwiki)。
階段 0:基礎工具箱,分析師可以壓到 1–2 週加 3–4 週
要學什麼。 進階 SQL:CTE、window function、recursive CTE、讀 EXPLAIN 和 query plan、partition pruning、nested/struct 型別。Python 當膠帶用:呼叫 API 時處理 pagination、retry 和壞資料,檔案 I/O,標準函式庫,Polars 或 pandas,pytest。另外還有 Linux/bash、Git 的分支與 PR 流程,以及最基本的網路觀念 (Start Data Engineering; Analytics Vidhya)。
為什麼。 Machado 認為,所謂進階 SQL 指的是「知道怎麼建模資料、怎麼有效率地做到」,不是背冷門語法 (Start Data Engineering)。他在 2026 年整理 AI 時代資料工程師的六項技能,第一項是「用 SQL 定義轉換,用 Python 黏合系統」,最後一項是「看懂 LLM 生成的程式碼」(Start Data Engineering 2026)。AI 會幫你寫,但你得判斷它寫得對不對。
過關標準。 看到一段 SQL,能說出它的 grain 和掃了多少資料。寫得出一支能分頁抓 API、失敗自動重試、有 logging、型別提示和 pytest 的 Python 腳本。在終端機完成 clone、開 branch、commit 和發 PR。網路方面合理的底線是懂 port、localhost 和容器網路的差別、SSH、環境變數與 secrets,以及 VPC 和防火牆的概念(推論)。
快速通道。 你的 SQL 和 Python 大概已接近入門 DE 的水準。SQL 用 1–2 週補 query plan 和 partition pruning 就好;比較多時間留給工程習慣:把 notebook 改寫成 package,加上 logging、retry 和 pytest,再加上 CLI 和 Git,大約 3–4 週。
推薦資源。 Start Data Engineering 的進階 SQL 系列,以及 DataExpert.io 免費 Community Boot Camp 的 analytical patterns 模組。
階段專案。 挑一份工作上每週都要手動重跑的報表 SQL,改寫成可以參數化日期、從 CLI 執行的腳本,並放進 Git 版控。
階段 1:建模,Power BI 使用者的主場
要學什麼。 依序學正規化與 OLTP、Kimball 維度建模(fact、dimension、grain、conformed dimension、Bus Matrix)、SCD Type 0/1/2 以及「每天存一份完整快照」的替代做法,然後是給下游用的 OBT(One Big Table)。Data Vault 只需要知道有這種東西。
為什麼。 Reis 說,以為有了欄式儲存和便宜的算力就可以不管 Kimball,是「危險的無知」(Joe Reis)。他 2026 年 2 月的調查(n=1,101)顯示,89% 的人說建模讓他們很痛苦,但只有 5% 在用 semantic model (Joe Reis)。這是目前最明顯、也最少人補的技能缺口。
SCD2 的另一派做法。 Beauchemin 主張與其用 upsert 維護 SCD2,不如每次執行都把整張 dimension 存成新的 partition 快照:簡單、可重現,而且儲存比工程師的時間便宜 (Maxime Beauchemin)。兩種都該會,面試時講得出取捨會加分。
過關標準。 拿到一個業務問題,畫得出 Bus Matrix,說得出每張 fact table 的 grain,用 SQL 或 dbt 建出 fact 和 dim,對商品價格或門市屬性做 SCD2,並會用 surrogate key。
快速通道。 Power BI 的關聯、fact/dim 和 grain 你每天都在用,概念可以快速帶過。要補的是把這些搬到上游:在倉儲裡用 SQL 建出來,而不是在 Power BI 模型裡拉關聯。便利商店的 POS 資料剛好就是 Kimball 零售銷售案例的翻版。
推薦資源。 Kimball 與 Ross 的 The Data Warehouse Toolkit、Start Data Engineering 的 fact/dim 與 SCD2 系列、DataExpert 的維度建模模組。
階段專案。 設計一套零售 star schema:fact_sales、dim_store、dim_product、dim_date,商品價格做 SCD2,並寫一份 grain 說明文件 (DataDriven)。
預估時間。 從零開始 3–4 週,分析師 1–2 週。
階段 2:第一條 pipeline,做完這關才算入門
要學什麼。 用 dlt 做 ingestion(incremental load、schema 推斷、state);用 dbt 建 staging 和 mart,寫 test、snapshot、incremental model;選一個排程工具(Airflow 3 優先);資料品質做 freshness、volume、schema、uniqueness、null 和 referential 檢查,以及 write-audit-publish;還有最關鍵的 idempotent 寫入與 backfill。
為什麼。 Idempotency 是整條水管的安全閥。Beauchemin 的原則是 task 要純粹、結果要確定,用整個覆寫 partition 取代 UPDATE 或 APPEND,重試和回補才安全。驗證方法很簡單:同一份輸入跑兩次,列數和內容都要一模一樣 (DataLakehouseHub)。
過關標準。 Pipeline 每天自動執行,故意弄壞某一天後可以安全回補;上游多了欄位或改了型別時會大聲失敗,不會默默寫進 NULL;README 寫了架構圖、grain、怎麼跑,以及一則失敗處理的故事。
推薦資源。 DataTalksClub Data Engineering Zoomcamp 模組 2–4(排程、dlt、BigQuery、dbt)。課程免費、約 9 週;只有參加 live cohort 完成期末專案並通過互評才拿得到證書。另可參考 Start Data Engineering 的新手 batch 專案。
階段專案。 對分析師最務實的切入點是 Machado 的建議:拿一個反覆出現的 ad hoc 查詢,定義清楚使用者、要解決什麼、多久更新,做成排程化的 SQL pipeline,套上 fact/dim 和 SCD2,demo 給使用者看,再請資深 DE 給意見 (Start Data Engineering)。工作以外,再做一條本機版本:公開 API → dlt → DuckDB/Postgres → dbt → Airflow → Power BI,全部放進 Docker Compose。
預估時間。 6–8 週,分析師在這關省不了多少時間。
階段 3:雲端與工程化,把水管搬上雲
要學什麼。 Docker/Compose;選一個雲(台灣建議 GCP BigQuery 或 AWS);IAM、PII 與治理的基本觀念;BigQuery 的 partitioning 與 clustering;Parquet;GitHub Actions 在每個 PR 跑 dbt build;Terraform 入門。
為什麼。 Stack Overflow 2026 年調查中,Docker/Compose 使用率 59.1%,Kubernetes 26%,Terraform 18.3% (Virtualization Review)。Docker 是必修,Terraform 和 K8s 是加分項。雲端費用跟處理的資料量成正比,所以儲存要為讀取最佳化。
過關標準。 別人 git clone 你的專案後,一行指令就能在本機跑起來。雲端資源用 Terraform 建,刪掉可以重建。PR 沒通過測試不能 merge。你說得出某支查詢掃了多少 bytes、花了多少錢。
推薦資源。 Zoomcamp 模組 1(Docker、Postgres、Terraform、GCP)。證照可考慮 GCP Professional Data Engineer(US$200)或 AWS Data Engineer Associate(US$150,65 題、130 分鐘)(DataCamp; Careery)。
階段專案。 把階段 2 的 pipeline 搬上 BigQuery,用公開的零售類資料,包含 star schema、SCD2 商品維度、一次 backfill 示範、一次 schema 變更示範,並用 Terraform 和 GitHub Actions 管理。
預估時間。 階段 2 加階段 3 合計約 8–12 週。
階段 4:進階,碰到限制再打開
要學什麼。 Spark 內部機制(shuffle、broadcast join、AQE、skew);Lakehouse 與 Iceberg 概念(snapshot、catalog、time travel);Kafka 基本觀念(topic、partition、consumer group、exactly-once)與 schema registry,需要時再學 Flink;cost/FinOps;governance、lineage 和 catalog;semantic layer;RAG 與 embedding pipeline。
為什麼。 平台正在收斂:Snowflake 與 Databricks 都已 GA 支援 Iceberg v3,Apache Polaris 在 2026 年 2 月 18 日成為 Apache 頂級專案 (Data Lakehouse Hub,作者任職 Dremio,觀點可能偏向廠商)。Reis 的調查顯示 44% 的團隊用 warehouse、27% 用 lakehouse、12% 混合 (Joe Reis)。
過關標準。 在 Spark UI 看得出哪個 task 因為 skew 拖慢整個 stage 並修好它;說得出 Iceberg 刪資料後舊檔案為什麼還在;用 Kafka 搭一條模擬 POS 事件的串流,並解釋 at-least-once 為什麼會造成重複、怎麼去重。
階段專案。 模擬 POS 事件 → Kafka/Redpanda → Flink 或 Spark → Iceberg;或用 Spark 處理比記憶體還大的資料集,加上成本監控。
預估時間。 3–6 個月,視目標職缺而定。
你手上已經有的資產
經濟與因果推論的訓練派得上用場:DataExpert 把 KPI 與實驗設計列為獨立模組,semantic layer 和指標治理正是 2026 年缺人的地方。一個抓評論、做情緒分析的 side project,只要補上排程化的 incremental 爬取、idempotent 載入、dbt test、CI 和品質儀表板,就能從「分析作品」變成「工程作品」(DataDriven)。
2026 工具選擇:先學概念,再挑一個代表工具
2026 年的併購潮說明了為什麼不要把學習押在單一品牌上。Fivetran 和 dbt Labs 於 2026 年 6 月 1 日完成合併,Fusion 引擎以 dbt Core v2.0(alpha,Apache 2.0)開源 (Fivetran);Fivetran 在 2025 年 9 月已買下 SQLMesh 的母公司 Tobiko Data (BusinessWire)。IBM 以 110 億美元買下 Confluent,3 月 17 日完成 (StockTitan / IBM)。
| 類別 | 先學 | 之後再學 | 為什麼 |
|---|---|---|---|
| 雲端倉儲 | BigQuery(台灣)或 Snowflake | Databricks | BigQuery 有免費 sandbox,台灣行銷與廣告類職缺常見 (Cake) |
| 表格格式 | Iceberg 概念 | Delta(Databricks 環境) | 四大平台都支援 Iceberg (Data Lakehouse Hub) |
| 本機引擎 | DuckDB | Polars | dbt v2 的 DuckDB adapter 已 Generally available(僅 CLI)(dbt adapter 支援表) |
| 轉換 | dbt(Core v1 或 Fusion VS Code 擴充) | SQLMesh 概念 | 截至 2026-10-14,dbt v2 的 Snowflake、BigQuery、Databricks、Redshift、DuckDB(僅 CLI)adapter 已 Generally available;Spark 為 beta,ClickHouse 為 private beta (dbt adapter 支援表) |
| 排程 | Airflow 3 | Dagster | Dagster 在小公司使用率 12%,大企業只有 2.6% (Joe Reis) |
| Ingestion | dlt(Python) | Fivetran/Airbyte 概念、Debezium CDC | Fivetran 按 MAR 計價,費用可能急遽攀升 (Bruin,廠商文章) |
| 處理 | SQL + PySpark | Flink(串流職缺才需要) | Spark 仍是大數據職缺的基本要求 |
| 串流 | Kafka 觀念 | MSK / Confluent / Pub/Sub | 台灣有職缺用 Amazon MSK 搭配 managed Airflow (Cake) |
| 資料品質 | dbt tests + data contracts | Soda/GX、OpenLineage | 門檻最低,品質工具市場還在洗牌 |
| 基礎設施 | Git、Docker、GitHub Actions | Terraform、K8s 基礎 | Docker 使用率 59.1% (Virtualization Review) |
| AI 時代 | 建模 + semantic layer | RAG/embedding pipeline、pgvector | 82% 每天用 AI,但只有 10% 真正嵌進工作流程 (Joe Reis) |
| 雲端平台 | 依目標雇主選 GCP 或 AWS | 另一個 | 全球 AWS 41.8%、Azure 25.1%、GCP 24.5% (Virtualization Review) |
排程工具的概念(DAG、retry、backfill、資料感知相依)學好,工具挑一個就夠。想進台灣市場,Airflow 3 最穩:Cake 上「Airflow」台北的搜尋結果第一頁 10 筆職缺全都提到它,但這只是快照,不是市占率。Power BI 使用者也可以留意 Microsoft Fabric 的 DP-700 證照(約 US$165),它是新考試,對求職的效果還沒經過驗證 (DataCamp)。
實務上會遇到的問題:多半不會報錯,只是數字不對
Monte Carlo 2023 年調查 200 位資料從業人員:團隊平均每月 67 起資料事故,68% 要 4 小時以上才發現,平均修復約 15 小時,74% 說多半是業務端先發現問題 (BusinessWire / Monte Carlo)。job 大聲失敗的成本,遠低於 job 成功卻寫進錯誤資料。標「(示意)」的便利商店例子是為了說明機制設計的情境,不是真實事件。
資料品質類
1. 資料晚到(late-arriving data)
- 症狀: 昨天的營業額接下來幾天還在慢慢往上加,同一天的報表數字隨查詢時間不同。
- 原因: pipeline 只處理一次「昨天的 partition」,但離線門市補傳或付款延遲確認的資料會晚到。
- 怎麼處理: 每次重跑最近幾天的 lookback 視窗,用 partition overwrite 或 MERGE 寫入;dbt microbatch 的
lookback設定就是為此設計 (dbt docs)。串流系統用 watermark 決定最多等多久 (RisingWave)。另外發布「資料完整至何時」的標記。 - 例子(示意): 某門市 POS 半夜斷網,02:00–06:00 的交易到 10:00 才補傳,08:00 的日結 job 已關帳,報表上那間店業績突然下滑。
2. 重複資料
- 症狀: 出過事故或重跑之後,營業額和訂單數膨脹。
- 原因: job 載入 10 萬筆後下一步失敗,排程器整批重跑又盲目 APPEND 一次,變成 20 萬筆 (DataLakehouseHub)。
- 怎麼處理: 用業務鍵 MERGE(例如
order_id + line_no),主鍵加 uniqueness test。Uber 把重複主鍵比例列為標準檢查 (Uber Engineering)。 - 例子(示意): 支付 webhook 重送,同一個
order_id進來兩次,促銷 ROI 被高估。
3. Schema drift(上游悄悄改了結構)
- 症狀: job 失敗;更糟的是 job 成功,但寫進一堆 NULL。
- 原因: 上游沒通知就改欄位名稱或型別;更難發現的是語意漂移,例如三張表裡有三種沒寫下來的「活躍會員」定義 (HackerNoon)。
- 怎麼處理: 在 ingestion 端檢查 schema contract,不符合就大聲失敗並通知生產者;用 YAML 寫 data contract、在 CI 驗證,先從最痛的 3–5 張表做起。
- 例子(示意): 會員 App 改版,把
store_code改名成store_id,新會員的點數儀表板全部顯示為 0。
4. 時區
- 症狀: 日營業額跟財務或 POS 日結對不起來,差額集中在午夜前後。
- 原因: 事件以 UTC 儲存也用 UTC 切日,台灣 UTC+8,00:00–08:00 的交易會被算到前一天。
- 怎麼處理: 以 UTC 加明確 offset 儲存,在一個共用 model 裡依門市當地時區產生
business_date,並把營業日切點寫成文件(這張卡是從原理推導,沒有公開事故報告)。 - 例子(示意): 跨夜時段的業績全部算到前一天,週一業績看起來特別好。
5. NULL 與靜默資料損壞
- 症狀: 列數下滑、null 比例上升,好幾天後才有人覺得儀表板怪怪的。
- 原因: 只監控 task 有沒有成功,沒監控資料本身。
- 怎麼處理: staging 層做衛生測試(主鍵 unique + not null、必要欄位有值、格式檢查),再從最常用的 1–3 個儀表板倒推業務異常測試 (dbt blog)。Uber 的標準維度是 Freshness、Completeness、Duplicates。
- 例子(示意): 商品分類對照表少了一批新品,join 後這些銷售全被丟掉,總營收少了 2%,沒有人發現。
可靠性類
6. Backfill 回補
- 症狀: 修好 bug 後要重算上一季,直接回補卻讓資料加倍,或撞到倉儲配額。
- 原因: 寫入不是 idempotent,回補和日常 job 擠在同一份算力上。
- 怎麼處理: partition overwrite、業務鍵 MERGE、串流端去重;回補分批、用獨立算力,事先通知下游,事後核對前後總數。
- 例子(示意): 修正稅額與折扣邏輯後,重算 90 天的門市日銷售。
7. 上游晚了,下游照跑
- 症狀: 下游 job 顯示成功,用的卻是舊資料。
- 原因: 用 cron 時間差排相依,例如固定比上游晚 1 小時。
- 怎麼處理: 改成資料感知的相依(sensor 或 freshness 檢查)。Uber 把 Freshness 設為父檢查,失敗時壓下子告警,一個根因只響一次 (Uber Engineering)。
- 例子(示意): 會員資料晚到,日報照樣用前一天的會員數算客單價。
8. 告警疲勞
- 症狀: 每天幾十個測試失敗,大家乾脆不看。
- 原因: 所有告警丟進同一個頻道、門檻沒跟著業務調整。Dengsøe 用「破窗」比喻:被忽略的失敗會讓人學會忽略所有失敗 (Mikkel Dengsøe)。
- 怎麼處理: 每個 model 定 owner 和重要程度,告警直送 owner;每月清理,沒有測試連續失敗超過 5 天;只有影響客戶、財務或主管報表的測試設成 error,說不出怎麼除錯的測試就刪掉 (dbt blog)。
- 例子(示意): 新品上市季,「日銷售變動不得超過 20%」一週響五次,得重新校準門檻。
效能與成本類
9. 雲端帳單爆炸
- 症狀: 月底收到帳單才發現暴增。
- 原因: BigQuery on-demand 每 TB US$6.25,
LIMIT不會減少掃描量;把 partition 欄位包在 BigQuery 不支援 pruning 的運算式裡(如轉成STRING或FORMAT_TIMESTAMP(...)),或拿它和非常數運算式比較,都可能讓 pruning 失效;on-demand 預設沒有支出上限 (CloudKeeper)。 - 怎麼處理: 設 maximum bytes billed、使用者配額、預算告警,code review 先 dry run;舊版 streaming inserts API(
insertAll)每 200 MB 收 US$0.01,約 US$50/TB;建議使用的 Storage Write API 為 US$0.025/GiB,每月前 2 TiB 免費,批次載入仍免費 (BigQuery pricing)。若仍用insertAll且不需要秒級延遲,可改成每 5–10 分鐘批次載入,省下舊版串流費用。 - 例子(示意): 分析師用 Power BI DirectQuery 接上整張交易明細表,每次開報表都全表掃描。
10. Partition 設計錯誤與 small files
- 症狀: 查詢很慢,檔案數量爆多。
- 原因: 用
store_id切 partition,幾千間門市切出一堆小 partition,最常見的「所有門市最近 7 天」反而用不到。 - 怎麼處理: 依
business_date切 partition,再依store_id/skuclustering;Delta 可開optimizeWrite,對高基數篩選欄位做 OPTIMIZE/Z-ORDER (dev.to)。
11. 資料傾斜(skew)
- 症狀: 一個 task 跑好幾分鐘,同 stage 其他 task 幾秒就完成。
- 原因: hot key。
- 怎麼處理: salting 或開啟 AQE skew join;注意 broadcast 門檻預設 10MB,dimension 表悄悄長大後會退化成 shuffle join。
- 例子(示意): 非會員交易的
member_id都是'0000',形成超大 hot key,先濾掉或加 salt。
組織與治理類
12. 指標定義之爭
- 症狀: 商品部說既存店成長 3%,財務說 1%。
- 原因: 既存店是開幕滿 12 還是 13 個月、含稅或未稅、退貨有沒有扣、營業日切點在哪。
- 怎麼處理: 在 semantic layer 維護一份受治理的定義,指定業務 owner。Airbnb 的 Minerva 走「define once, use everywhere」,從 2017 年做到 2020 年成為全公司指標的單一真相來源,管理超過 12,000 個指標 (dbt Roundup)。DE 的工作是把分歧攤開,不是自己選邊。
13. ad hoc 需求淹沒 roadmap
- 症狀: 同一個問題在三個私訊裡各回答一次,排定的工作做不完。
- 原因: 需求從私訊進來,沒有追蹤。
- 怎麼處理: 導到共用頻道或工單,分成 backlog、排程、立即處理三類,問清楚數字要做什麼決策 (Data Products)。重複出現的問題做成自助資料集。每個上線的 model 都是維護承諾,可能占掉一個人 2–20% 的時間。
14. PII 散落與個資法
- 症狀: 會員手機號碼出現在幾十個 sandbox 和 CSV 匯出檔裡。
- 原因: 為了方便,原始會員表到處被 join。
- 怎麼處理: ingestion 端就 tokenize,對照表放在權限受限的 vault;倉儲用欄位遮罩和 row-level policy。注意 Iceberg 的刪除不會真的毀掉資料,硬刪除需要整套 runbook 或 crypto-shredding (DataLakehouseHub)。
- 台灣個資法: 2025 年 11 月 11 日公布的修正案設立個人資料保護委員會(PDPC),外洩時要通知當事人並依條件通報,違反安全維護義務屆期未改正可按次處 15 萬至 1,500 萬元 (K&L Gates)。施行日期未確認,請以 PDPC 公告為準。
15. 系統遷移對不起來
- 症狀: 搬到雲端後總數一樣,明細不一樣。
- 原因: 對帳靠人工比列數;常見差異來源是時間戳語意、金額小數精度、NULL 與空字串、排序規則、整數除法。
- 怎麼處理: 依序做列數 → 欄位加總 → schema → 雙向 EXCEPT → 每列 hash 比對,從第一天就排程驗證。列數和加總都對,不代表每一列都對 (Databricks Community)。
出事之後:沿著 lineage 往回找,再補一個測試
除錯順序:重現問題 → profiling → 沿 lineage 往上下游追 → 找上游工程師 → PR review 修正 → 告訴使用者影響範圍與現在該怎麼用 (Data Products)。規則只有一條:使用者發現了測試沒抓到的問題,就補一個測試。值得長期追蹤的指標是「使用者比資料團隊先發現問題的比例」。
台灣求職:先走 analytics engineer 這一步最順
台灣 DE 職缺的共同要求是 Python、進階 SQL、ETL 與 pipeline 經驗、一個雲端平台、Git 和 Linux;Airflow、Docker/K8s、Spark/Hadoop 常列為加分項 (104職場力; Michael Page TW)。市場大致可分成幾類(推論分類):
- 金融與傳產: 地端 Hadoop/Hive 加 MSSQL/Oracle,正在上雲。
- 網路、電商、遊戲、廣告科技: GCP/BigQuery 或 AWS,加上 Airflow、dbt、Kafka。iThome 鐵人賽有團隊分享從 Airflow 觸發
dbt build --select +tag:daily的做法 (iT邦幫忙)。 - 半導體與製造: Python + SQL + Airflow + K8s,重點放在 AI。
- 外商或區域型科技公司: 薪資明顯較高。
薪資資料很分散,參考價值有限。 104 薪資情報的月薪平均:3 年以下約 5.9 萬,3–5 年約 6.4 萬,5–10 年約 6.6 萬,但沒寫年份與計算方法 (104職場力)。CakeResume 上金融科技的 Senior DE(4 年經驗)年薪 120–160 萬,Sr. BigData Engineer/TL(5 年經驗)180–250 萬,其中一份 JD 已明確寫到「AI coding tools」(CakeResume)。把 104 的平均當下限而不是目標比較合理。
轉職路徑。 分析師帶得走的是 SQL、對資料品質的直覺、領域知識和溝通能力;缺的是 pandas 以外的 Python、ETL 設計、Spark/Kafka、雲端,以及 Docker、Terraform、Git (Interview Query)。Analytics engineer 通常比較容易進入,在成熟團隊裡薪資常常接近 DE (Data Engineer Academy)。比較穩的順序是:
- 分析師 → AE:dbt、倉儲建模、Git/CI。
- AE → DE:排程、ingestion、IaC、Spark/串流。
風險最低的做法是在公司內部轉:接下一條既有的報表 pipeline(例如 POS 或會員資料 → DW → BI),重構成有測試、有版控的 dbt model 交給排程器跑,換 title 之前就先有 production pipeline 的實績。台灣的職稱很亂,「資料工程師」、「大數據工程師」、「Backend (Data)」都可能是 DE 的工作,要看 JD 內容判斷。
作品集與面試。 兩三個做完整、用真實且持續更新資料的 end-to-end 專案,勝過一堆照教學做的複製品。扣分:沒有 README、照抄教學、secrets 寫死。加分:架構圖、測試加 CI、技術棧對得上目標 JD。資料品質監控系統很少人做,容易讓人記住 (DataDriven)。面試常見題型有去重、sessionization、每組取 top-N、SCD 和 partition 技巧,SQL 和 Python 都要限時練習。本地作品集題材可考慮政府資料開放平台或 TWSE 每日行情的 incremental ingestion、YouBike 即時資料串流。
證照與書。 先上免費的 Zoomcamp,再依目標雇主考一張雲端證照:BigQuery 環境選 GCP PDE,企業、金融科技和 AWS 環境選 AWS DEA。dbt 認證(官方 US$200)可以當 AE 的訊號 (dbt Labs/Talview)。讀書順序:
- Fundamentals of Data Engineering:建立全局地圖。
- Kimball The Data Warehouse Toolkit:學建模。
- Designing Data-Intensive Applications 第二版(2026 年 2 月出版,新增 vector embeddings、durable execution):補系統設計。
結語
2026 年 AI 和工具併購越熱鬧,越該把時間花在不會過時的東西上:grain、idempotency、data contract、指標定義。Reis 預測「AI-assisted」到 2026 年底會從 JD 上消失,因為大家都會預設你會用 (Joe Reis)。到那時候,能拉開差距的是判斷 AI 寫出來的 pipeline 對不對,以及出事時能沿著 lineage 找到根因。
在零售業做分析的人,最大的優勢是已經知道「既存店」有幾種算法、POS 半夜斷網會發生什麼事。先把公司裡一條真實的報表 pipeline 做成有測試、可重跑、有 owner 的版本,用 AE 當跳板,再往 Spark、串流和 Lakehouse 延伸。這條路拿到 DE 的 title 較慢,但每一步都有成果拿得出來。
資料來源
- Joe Reis, The Data Engineering Lifecycle and Undercurrents, 4 Years Later
- Joe Reis, Where Data Engineering Is Heading
- Joe Reis, Is Kimball Still Relevant?
- DataTalksClub Data Engineering Zoomcamp
- DataTalks.Club podwiki, Data Engineer Roadmap
- DataExpert.io Free Community Boot Camp
- Start Data Engineering、6 skills in the age of AI、Analyst to DE、Beginner batch project、Advanced SQL
- Analytics Vidhya, Data Engineer Roadmap 2026
- Data with Baraa, The Ultimate Data Engineering Roadmap
- Maxime Beauchemin, Functional Data Engineering
- Data Lakehouse Hub, Iceberg market 2026
- Fivetran + dbt Labs merger
- dbt docs, Fusion availability、lookback、Test smarter not harder
- BusinessWire, Fivetran acquires Tobiko Data
- Bruin, Best data ingestion tools 2026
- StockTitan / IBM, Confluent acquisition
- Virtualization Review, Stack Overflow Survey 2026
- Cake: Airflow Taipei、BigQuery Taipei、Kafka Taiwan
- Monte Carlo 2023 survey via BusinessWire
- RisingWave, watermarks and late data
- DataLakehouseHub, Idempotent pipelines、GDPR hard deletes on Iceberg
- Uber Engineering, Operational excellence in data quality
- HackerNoon, Data contracts
- Mikkel Dengsøe, Broken windows
- dev.to, Spark performance on Databricks
- CloudKeeper, 10 costly BigQuery mistakes
- dbt Roundup, Robert Chang on Minerva
- Data Products, The data quality resolution process
- K&L Gates, Taiwan PDPA amendments
- Databricks Community, Migration validation
- 104職場力, 資料工程師職涯
- Michael Page Taiwan, Sr. Data Engineer
- iT邦幫忙, 解耦 Airflow 與 dbt
- Interview Query, Data analyst to data engineer
- Data Engineer Academy, Analytics engineer vs data engineer
- DataDriven, Data engineer portfolio
- DataCamp, Best data engineer certifications
- Careery, AWS Data Engineer certification guide
- dbt Labs / Talview certifications
- O'Reilly, Fundamentals of Data Engineering
- O'Reilly, Designing Data-Intensive Applications 2e